Vers une plateforme de modèles
1 - Un cas presque fictif
Imaginez. Vous êtes head of data d'un important site de e-commerce et on vous demande de créer un modèle de machine learning permettant d'estimer la probabilité de défaut de remboursement sur un paiement en 3 fois sans frais, utilisé par les clients pour régler leur commande. Le contrôle de gestion estime que les défauts de paiement sont trop nombreux et qu'il faudrait essayer de les réduire en ne proposant pas ce mode de paiement à des clients à haut risque de défaut.
Disposant d'un historique de données suffisamment fourni (dans les règles du RGPD), vous missionnez donc un de vos data scientists pour qu'il construise ce modèle de machine learning. Le data scientist s'attelle à la construction du modèle. Il construit la base de données d'apprentissage en extrayant les informations permettant de modéliser le risque d'impayé, parmi lesquelles la civilité du client.
Quelques semaines plus tard, le data scientist annonce que son modèle est prêt.À la suite d'une réunion, la décision est prise (et enregistrée dans un ADR) de déployer le modèle sous forme d'API.
Quelques jours, voire quelques semaines plus tard, on vous annonce que le modèle a été déployé. Les premiers mois montrent une réduction du nombre d'impayés avec un impact acceptable sur le taux de conversion.
Plusieurs mois plus tard, le service responsable des paiements signale en réunion que le taux de paiement en 3 fois est à 0 depuis quelques jours. Après investigation, il s'avère que l'API du modèle est tombée : le modèle n'est plus servi, et la règle de repli refuse donc ce mode de paiement à tous les clients !
Pire. Une cliente à qui le paiement en 3 fois a été refusé écrit au service client pour en connaître la raison. La réponse qu'elle reçoit ne l'explique pas (personne ne sait vraiment ce que le modèle regarde), elle dépose donc une plainte auprès de l'autorité responsable du sujet : la CNIL.
Celle-ci vous demande, pour ce modèle et pour tous vos modèles en production, les bases de données d'apprentissage, le descriptif des colonnes utilisées pour l'apprentissage, les métriques de performance, les métriques indiquant l'absence de biais, la gestion des risques, les logs du service, la présentation de l'interface de contrôle humain et une multitude d'autres informations de gouvernance et de prévention du risque. Vous ne pouvez en fournir qu'une partie. Et en relisant le descriptif des colonnes, vous découvrez que la civilité du client fait partie des variables du modèle (ce qui est interdit).
Nous sommes le 15 décembre 2027. Les obligations de l'annexe III de l'AI Act, sur les systèmes à haut risque, sont en vigueur depuis le 2 décembre 2027, et une entreprise ne les respectant pas risque jusqu'à 3% de son chiffre d'affaires mondial ou 15 millions d'euros d'amende. [0]
Pourtant, tout cela était évitable, grâce à la mise en place de bonnes pratiques MLOps notamment de monitoring [4][6] et de gouvernance. Et plutôt que d'en rester à la théorie, nous vous les montrerons à travers la solution packagée implémentée dans le cadre de notre projet de R&D de Tribu MLOps : une "model platform" qui permet de mettre en place toutes pratiques en quelques clics.
Les sections 2 et 3 expliquent ce qu'est une model platform et à quoi servent ses briques. Les sections 4 et 5 détaillent nos choix d'architecture et notre implémentation, pour ceux qui voudraient construire la leur.
La démo, en section 6, rejoue notre cas presque fictif avec la plateforme.
2 - Le concept de model platform
Pour reprendre la première slide de la conférence de Baptiste Courbe à la Grosse conf 2024 [1], la model platform est une solution centralisée pour versionner, déployer, héberger et monitorer tout type de modèles (car on le verra, les modèles ne sont pas que Machine Learning).
Elle assure la scalabilité, la gouvernance et la conformité des modèles. Pour résumer, elle simplifie l’intégration et la gestion des modèles.
L’idée de sa création part de plusieurs constats que nous avons fait dans nos expériences passées ou chez nos clients. En l’espace d’une dizaine d’années, nous sommes passés de modèle dans des notebooks, difficilement industrialisables, à la vague du MLOps avec l'émergence des bonnes pratiques sur l’industrialisation des modèles [2][3].
De nos jours, nous observons une augmentation du nombre de modèles en production répartis au sein de divers services, chaque service ayant ses propres méthodes de versionnement ou de déploiement. Si gouvernance il y a, elle se résume souvent à un serveur MLFlow commun à tout un service ou toute l’entreprise. Dans le pire des cas, il s’agit de l’instance MLFlow locale au poste du data scientist voire même d’un simple fichier excel permettant de loguer les expériences.
Pour le déploiement, nous avons remarqué que les équipes se posaient souvent les mêmes questions et qu’il était assez rare de voir des méthodes standardisées voir des solutions automatisées.
Ceci a un impact sur le délai entre la construction du modèle et son déploiement en production, hors un modèle de machine learning ne commence à générer de la valeur qu’à partir du moment où il est déployé en production et qu’il répond.
Sur ce dernier point, le monitoring apparaît comme une autre étape pour laquelle nous avons observé peu de standardisation et de centralisation. Il peut même arriver que cette brique soit complètement délaissé jusqu’à ce que les consommateurs de ces modèles viennent se plaindre que ceux-là ne répondent plus !
Enfin, le cadre juridique encadrant les modèles d’IA évolue. L’AI Act, encadrant les systèmes d’IA [5] en Europe impose des règles de gouvernance très strictes en fonction du niveau de classification de risque d’un modèle (système IA). Il entrera en vigueur intégralement à partir du 2 décembre 2027.
Hors, nous avons tous vécu des situations où nous avons dû fouiller dans d’anciens dossiers de code d’exploration, chercher le ou la data scientist responsable d’un modèle pour savoir sur quelles données le modèle avait été entraîné et quelle était la règle de gestion qui permet de construire une des colonnes du dataset d’inférence. Pour un modèle à haut risque, dans le cadre de l’AI Act, toutes ces informations devront être accessibles et auditables à la demande.
Avant la model platform: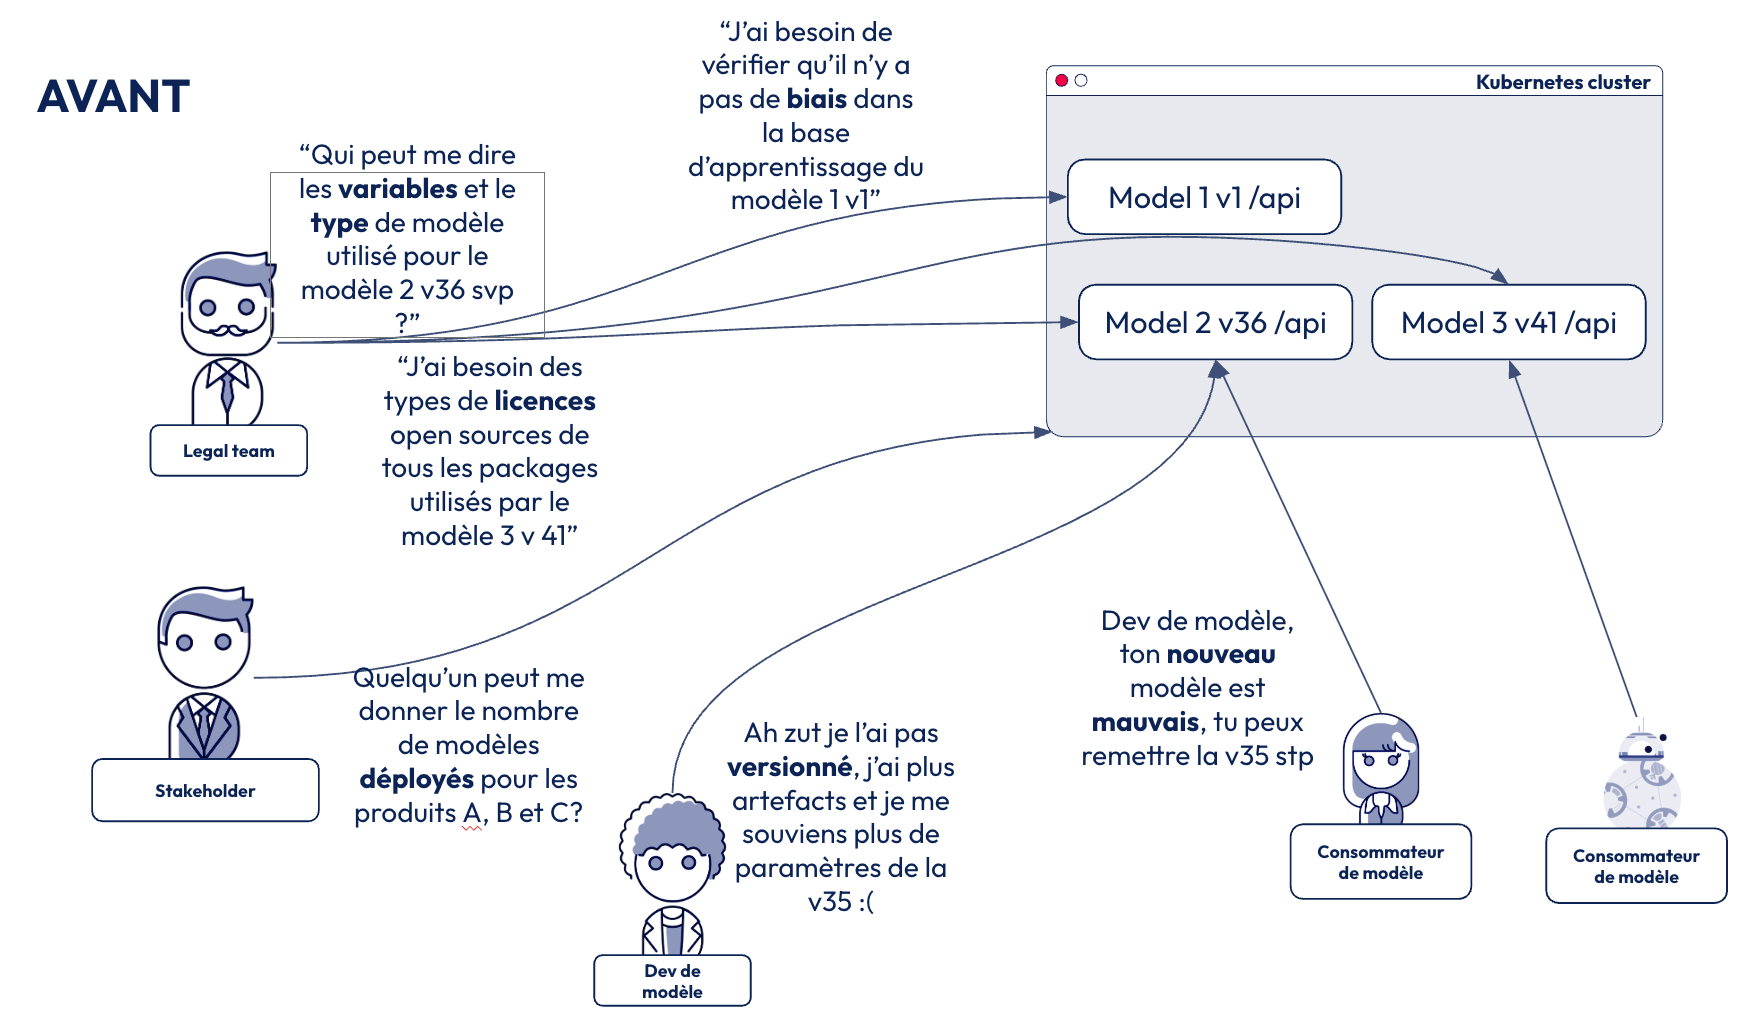
Avec la model platform :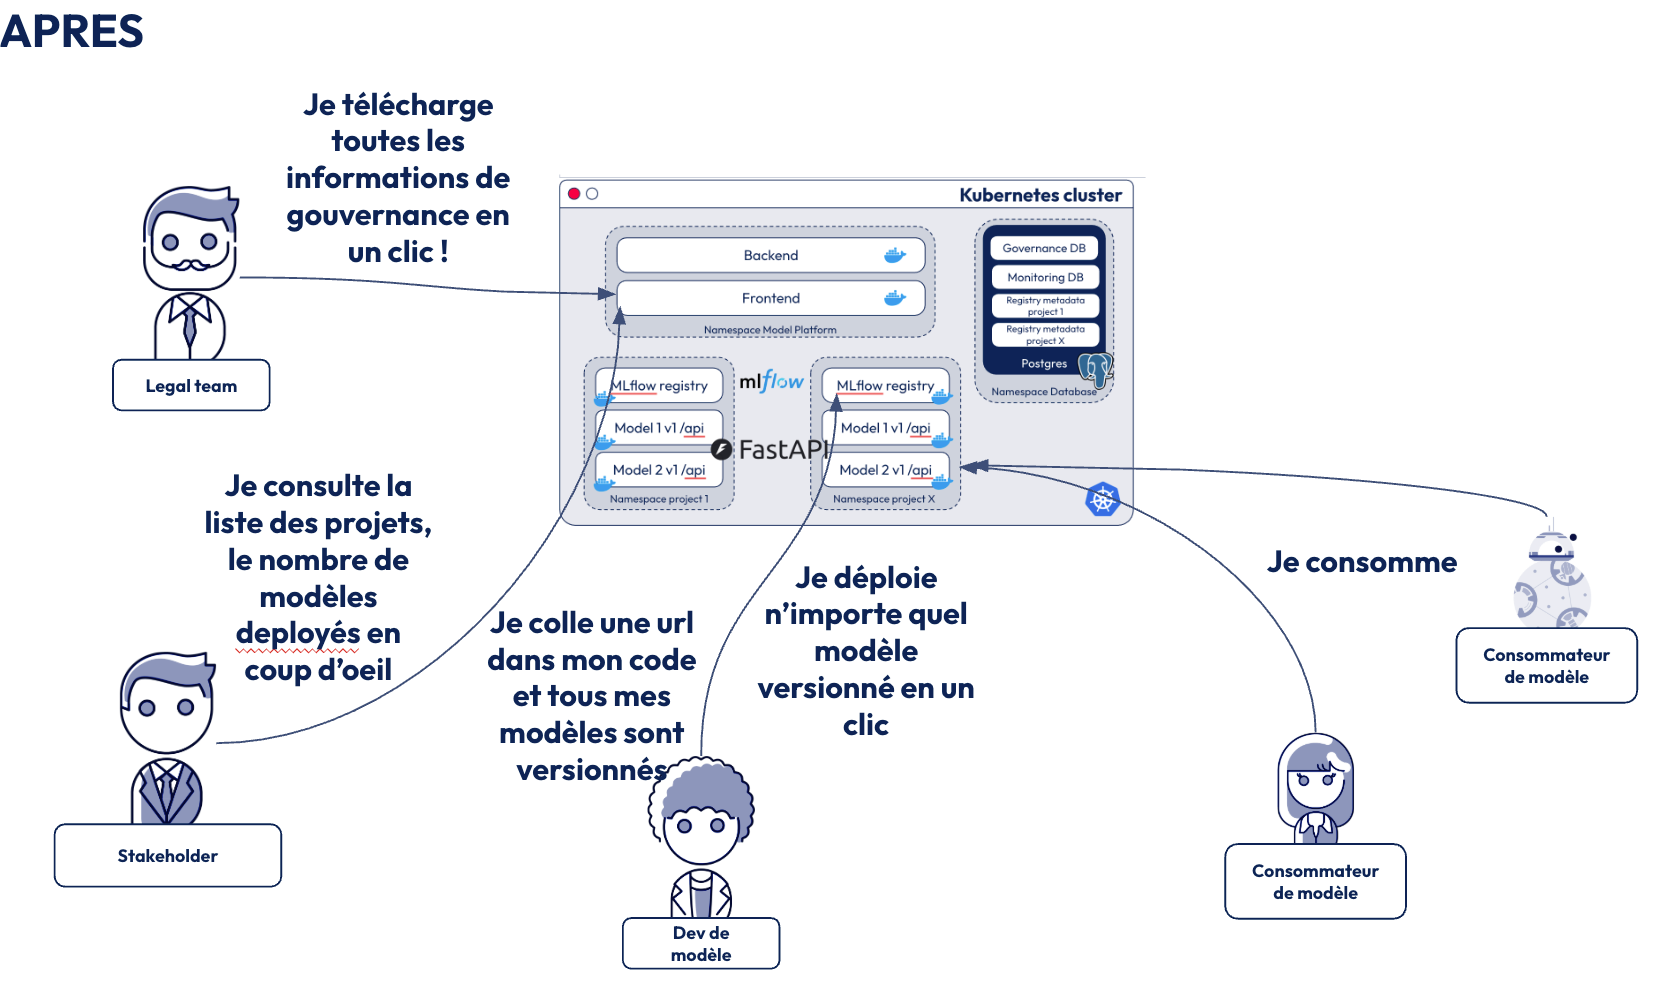
3 - Les composants de la model platform
Nous avons discuté du pourquoi. Parlons du comment. Notre model platform implémente cinq briques, visibles sur la figure 1. Avant d'entrer dans le détail de leur implémentation, voyons rapidement le rôle de chacune.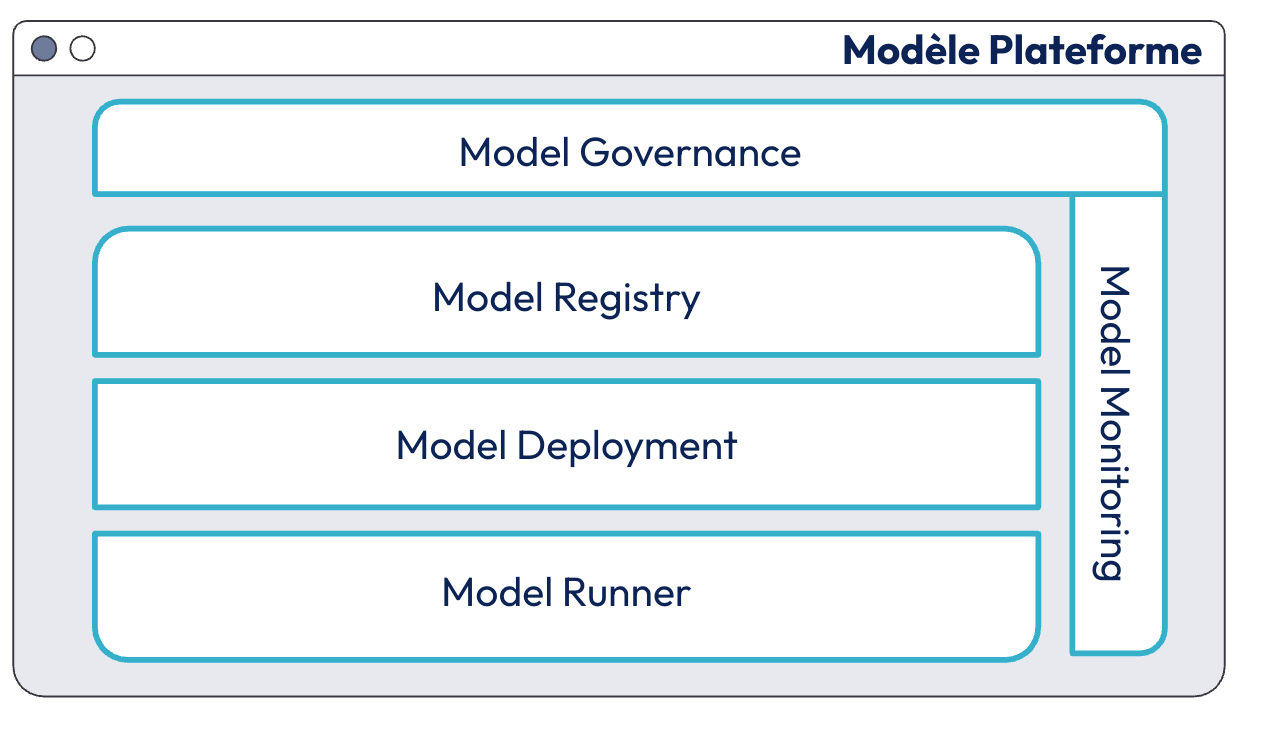
Le registre de modèles permet de versionner les modèles à un seul endroit. Chaque version y est conservée avec ses artefacts (les fichiers du modèle et ses dépendances) et ses métadonnées : auteur, paramètres, métriques, model card. C'est la source de vérité de la plateforme, dont partent toutes les autres briques.
Le déploiement transforme une version du modèle dans le registre en service accessible. Il prend en charge tout ce qui sépare un modèle enregistré d'un modèle en production (le packaging, la création des ressources sur l'infrastructure, l'exposition d'une url, etc.).
Le runner est ce qui tourne une fois le modèle déployé : le service qui charge le modèle et répond aux demandes de prédiction, en temps réel ou en batch.
Le monitoring observe les modèles en production (volume d'appels, latence, erreurs). Il traverse les trois briques précédentes, d'où sa position en colonne sur la figure 1.
La gouvernance, enfin, domine l'ensemble. Elle rassemble, pour tous les modèles de tous les projets, les informations permettant de savoir ce qui tourne, qui l'a déployé et sur quelles données le modèle a été entraîné, et de répondre aux exigences de l'AI Act. Elle permet une auditabilité complète du système.
Notre plateforme n'intègre pas de service d'entraînement. Nous estimons que les contextes pour l'entraînement et le réentraînement sont trop divers pour être standardisés. Nous avons préféré laisser le choix aux data scientists et ML engineers d'entraîner et de réentraîner leurs modèles sur le compute de leur choix. Leur environnement d'entraînement est en revanche connecté au registre de modèles.
4 - L'architecture de la plateforme
4.1 - Plusieurs options possibles
Avant d'implémenter notre plateforme, nous avons dû faire des choix d'architecture. Ce sont des choix que vous aurez, vous aussi, à faire si vous outillez vos équipes, et la bonne réponse dépend de votre organisation.
Lors des premières semaines du projet (en octobre 2024), nous avons dessiné plusieurs patterns, en fonction de l'endroit où vivent les 4 fonctionnalités principales d'une model platform : l'entraînement, le registre, le run (la capacité à faire des prédictions) et la gouvernance. Voici les patterns que nous avions identifiés : Décentralisé et centralisé
Décentralisé
Chaque projet possède son propre registre, son service d'entraînement et son backend, la plateforme se contentant de lire les registres pour la gouvernance. La scalabilité est infinie en nombre de projets, mais la gouvernance à l'échelle requiert plus d'intégration des informations de chaque projet, et les ressources de run et de registre déployées à chaque projet, ce qui peut poser des problèmes pour un nombre très important de projets.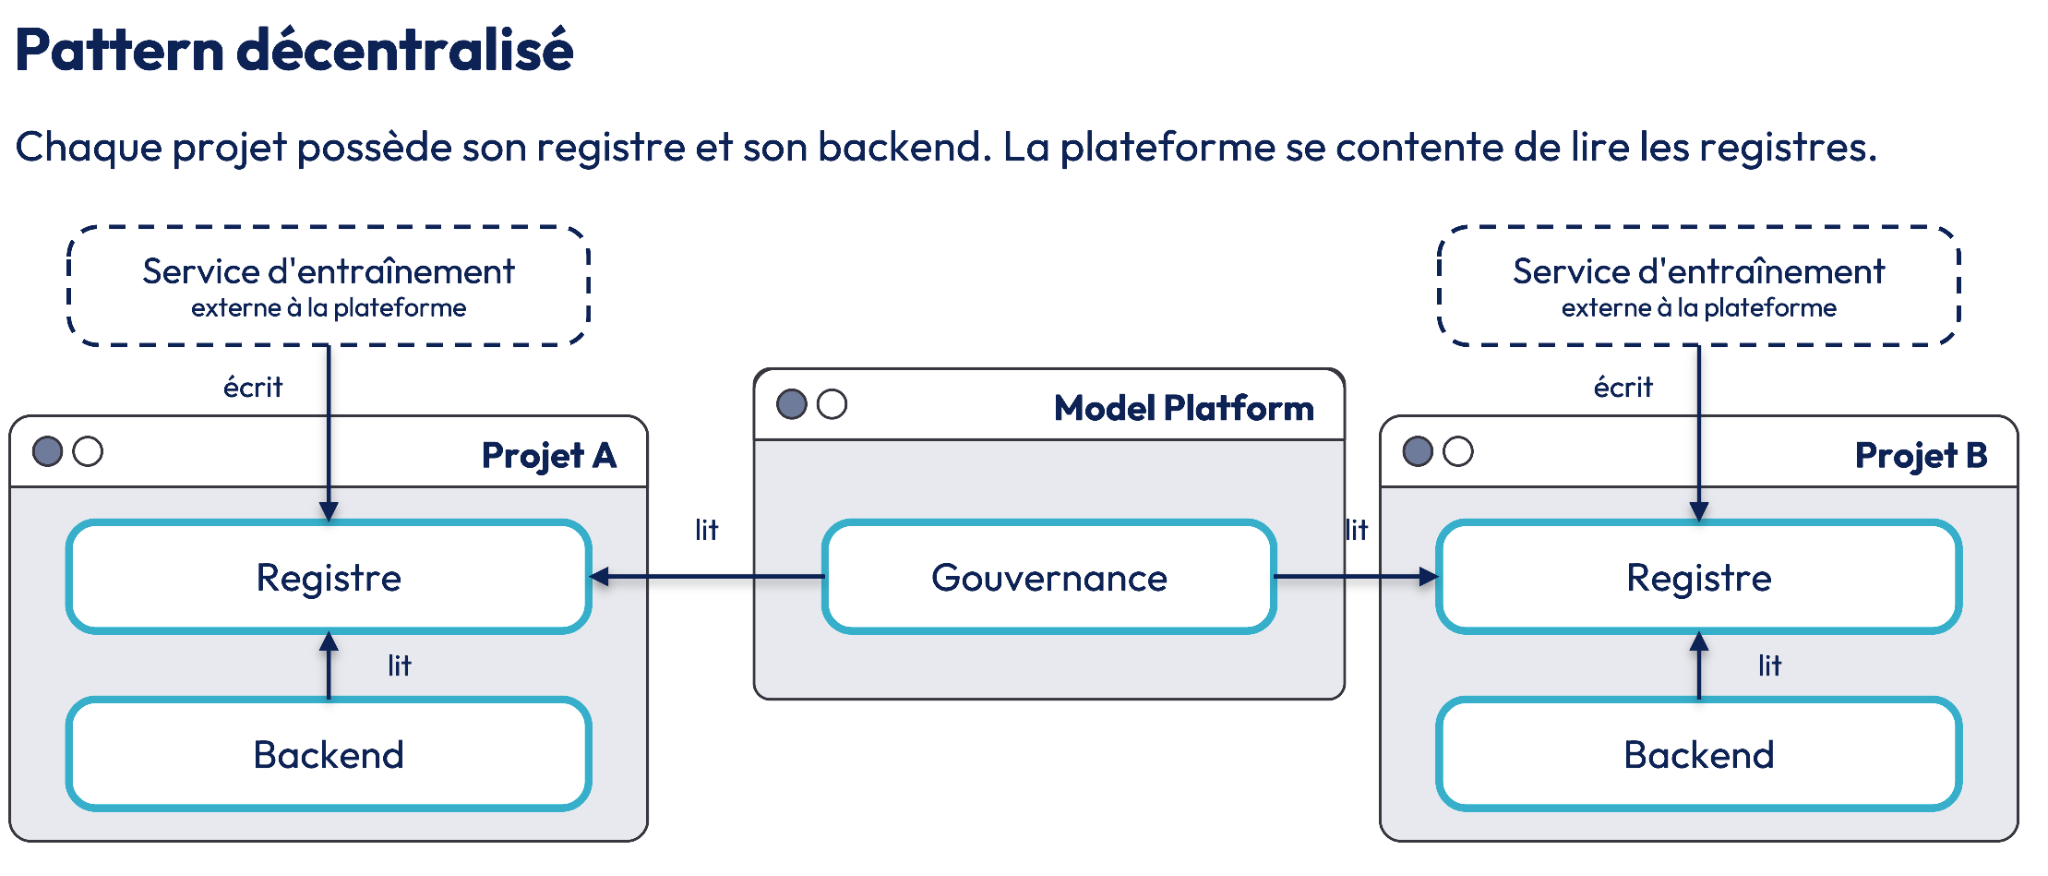
Registre centralisé
L'idée est d'avoir un seul registre de modèles, dans lequel tous les projets versionnent leurs modèles. La gouvernance est simplifiée, tous les modèles sont au même endroit. En revanche, ce registre unique peut devenir un goulot d'étranglement (les équipes n'utilisant pas MLflow de la même manière et avec la même intensité).
Registre et runner centralisés : en plus du registre, la plateforme héberge les modèles déployés. Le déploiement est standardisé et les métriques collectées sont les mêmes pour tous les modèles, au prix d'un appel supplémentaire entre le backend métier et le modèle.
Plateforme intégrée : tout ce qui touche aux modèles est centralisé, entraînement compris. Ce pattern convient aux organisations dans lesquelles une équipe centrale produit et opère les modèles pour les équipes produit.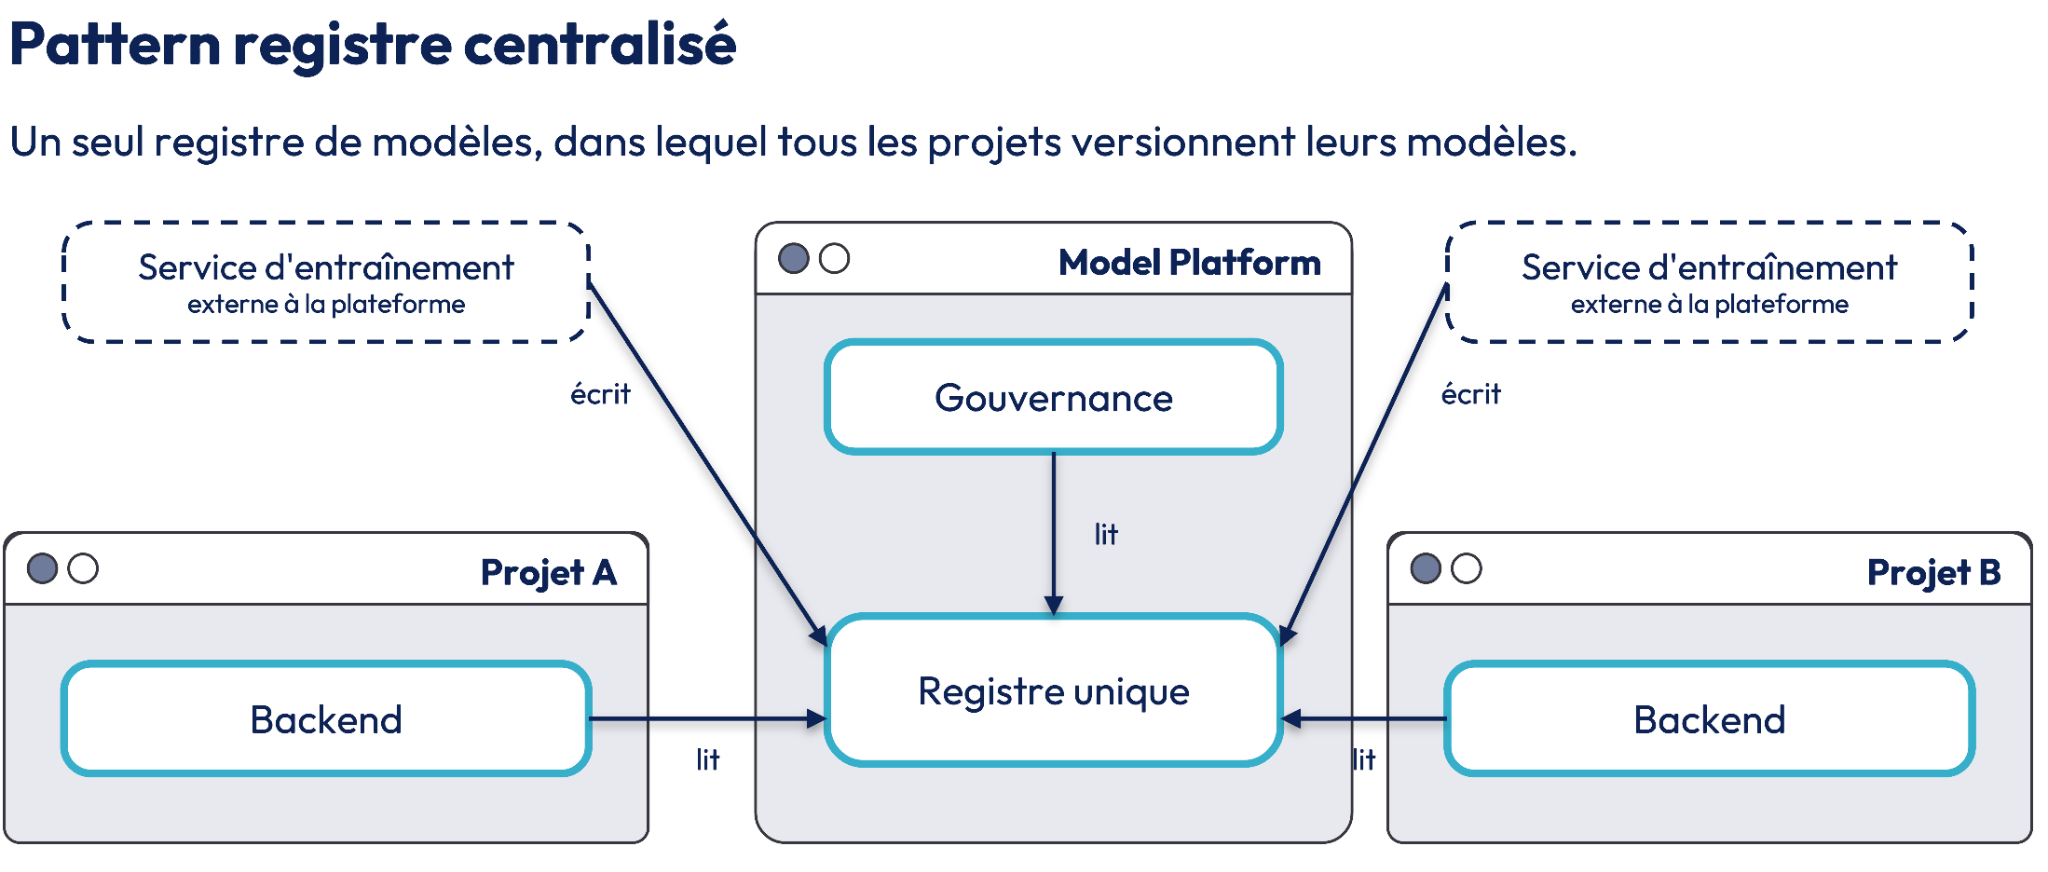
Le choix du registre
Très tôt, un autre choix s'est posé, celui du registre lui-même (c'est l'objet du tout premier ADR du projet) : utiliser MLflow, ou développer notre propre registre ?
Une solution maison nous aurait évité d'embarquer la partie expérimentations de MLflow, dont nous n'avions pas besoin. Mais il aurait fallu gérer nous-mêmes la sérialisation des pipelines d'inférence personnalisés, la réception d'artefacts volumineux via une API et la déclaration des dépendances du modèle, à la main, par la personne qui le pousse.
MLflow règle ces trois problèmes grâce à son format "pyfunc". Nous l'avons donc retenu, avec sa contrainte : un modèle MLflow est forcément rattaché à un run, ce qui impose un serveur, une base de données de métadonnées derrière chaque registre et un stockage objet pour les artefacts des modèles.
4.2 - L'architecture sélectionnée
Notre plateforme n'intégrant pas de service d'entraînement, le dernier pattern était écarté d'office. Pour notre implémentation, nous avons retenu un pilotage centralisé et une isolation par projet. Registres et modèles déployés sont hébergés et provisionnés par la plateforme, mais chaque projet a les siens. La possibilité d'avoir un registre MLflow par projet est pour nous un argument fort. Les ressources restent cloisonnées, et le contrôle des droits d'accès peut être fait au niveau de l'environnement hébergeant le registre.
La figure 4 présente l'architecture container qui en découle.
Architecture container de la plateforme : un cluster Kubernetes contenant le namespace de la plateforme, un namespace par projet, la base de données PostgreSQL et le monitoring, avec le stockage des artefacts à l'extérieur du cluster. Kubernetes a été choisi de manière à être agnostique de tout provider. Les principes et les briques restent néanmoins transposables sur tout type d’environnement.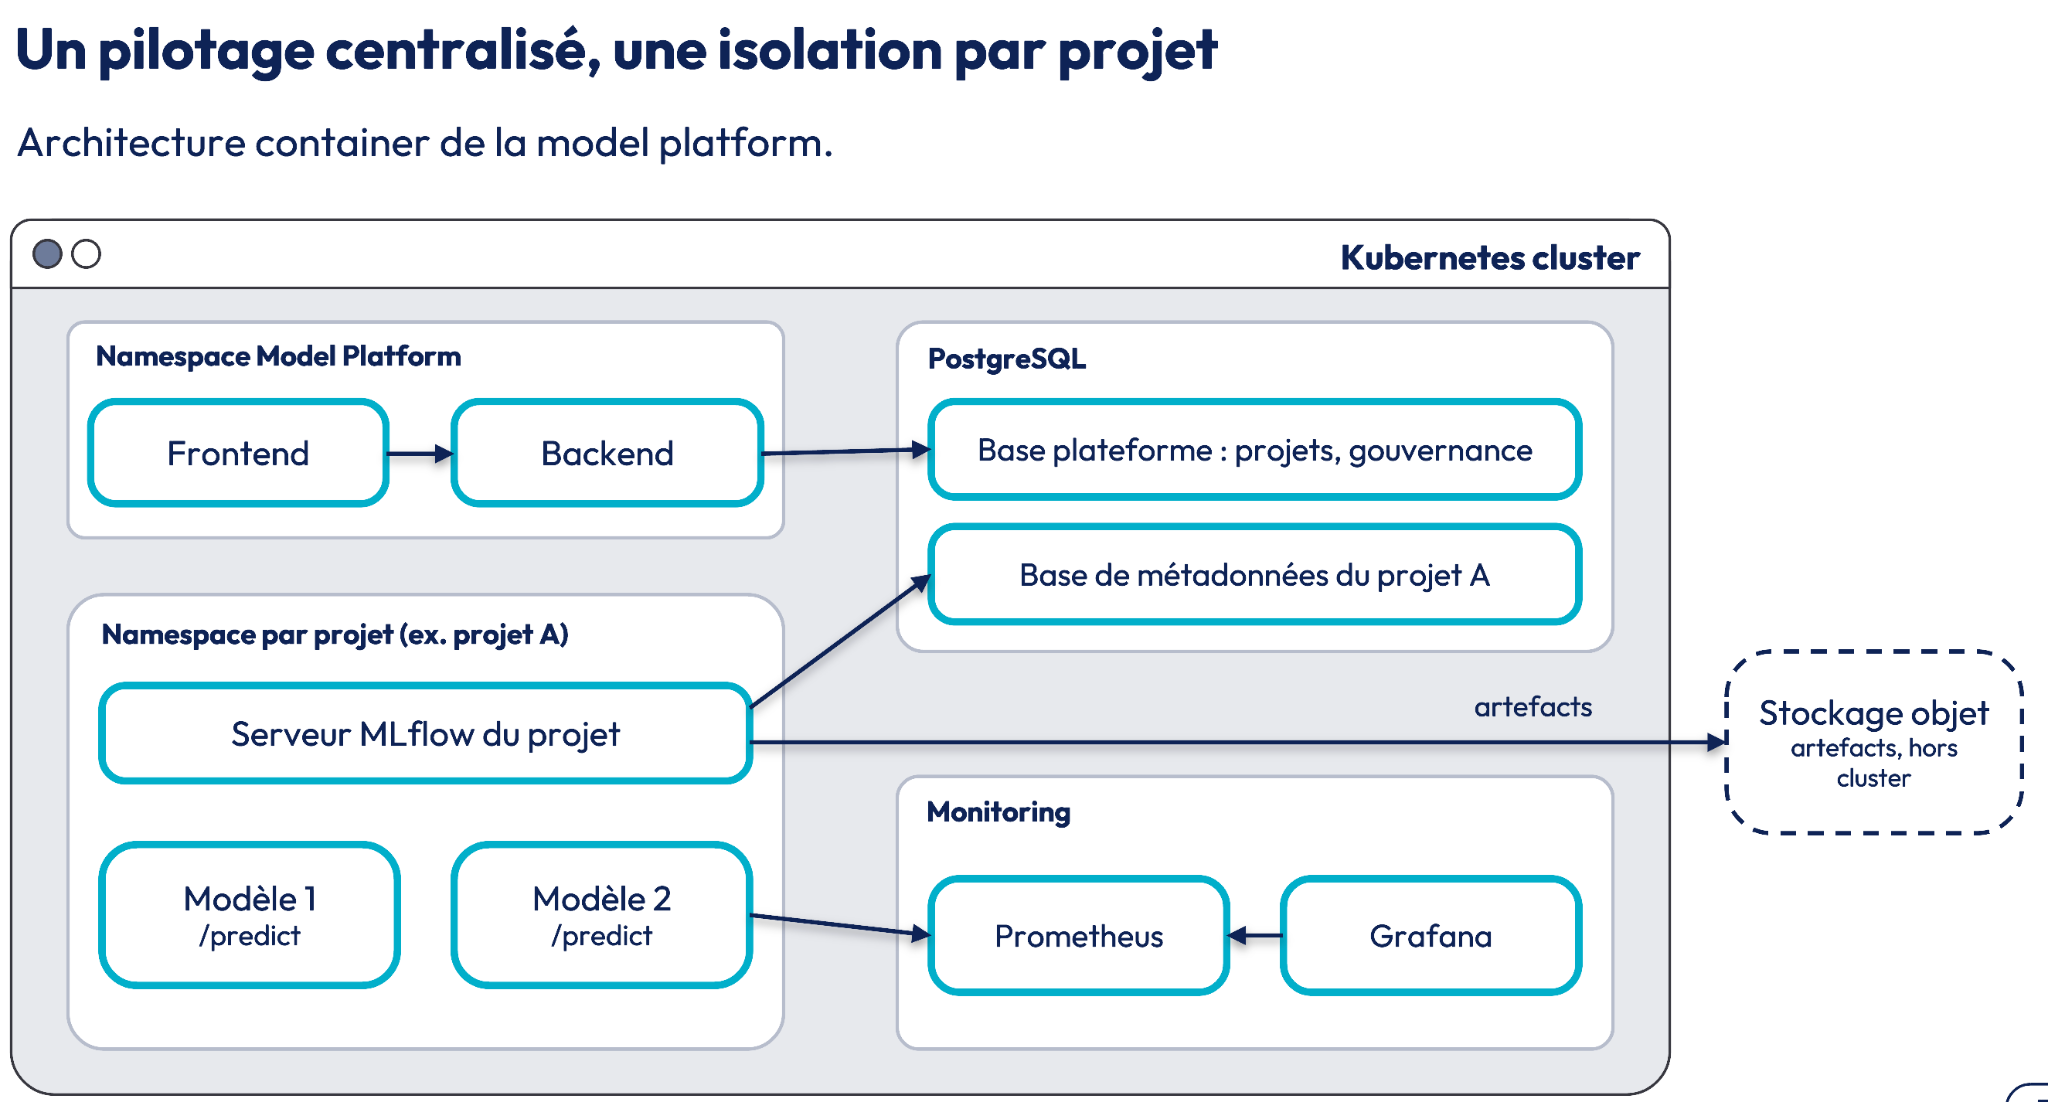
Commençons par le namespace de la plateforme, en haut à gauche de la figure. Il contient le frontend (l'interface utilisateur) et le backend, qui expose l'API appelée par l'interface et par la CLI. Le backend stocke et lit les données de projets et de gouvernance dans une base PostgreSQL dédiée à la plateforme. L’option d’avoir une base de données PostgreSQL par projet avait été envisagée mais elle a été jugée trop lourde. Le backend est aussi responsable du RBAC de la model platform.
Chaque projet dispose ensuite de son propre namespace Kubernetes, ici "Fraud-Detection-Payments". On y trouve le serveur MLflow du projet et les modèles déployés, chacun exposant sa route /predict. Le registre stocke les métadonnées des modèles (runs, paramètres, métriques) dans une base de données propre au projet, créée sur le serveur PostgreSQL au moment de la création du projet. Les artefacts, càd les fichiers du modèle et ses dépendances, sont stockés dans un bucket de stockage objet, à l'extérieur du cluster.
Enfin, sur la droite de la figure 4, le monitoring est commun à tous les projets. Les modèles publient leurs métriques dans Prometheus, et Grafana s'appuie sur ces métriques pour construire un dashboard par modèle.
Ce découpage a évidemment un coût. Créer un projet n'est plus une simple ligne en base de données, c'est un déploiement : un namespace, un serveur MLflow et une base de métadonnées. Il nous a fallu écrire une fois pour toutes la mécanique de provisioning.
En échange, un incident sur un projet reste confiné à ce projet. Une équipe est autonome sur son périmètre sans jamais toucher à celui des autres, et les droits sont attribués projet par projet, selon 4 rôles (viewer, developer, maintainer et admin). Seuls le serveur PostgreSQL et le stockage objet restent partagés, en tant que dépendances d'infrastructure de la plateforme.
5 - La mise en place, brique par brique
Voyons maintenant comment nous avons implémenté chaque brique, dans le cadre de cette architecture.
5.1 Le registre de modèles
L'objectif du registre de la plateforme est de permettre aux personnes qui entraînent des modèles de les versionner à un seul endroit, au sein de leur projet. Comme nous l'avons vu, nous avons choisi MLflow, qui est le registre open source le plus utilisé sur le marché. L'idée est vraiment de proposer, en un clic, un serveur déployé clé en main, dont il y a juste l'url à coller (et les informations d'authentification) dans son notebook ou son service d'entraînement pour voir ses modèles apparaître dans le registre.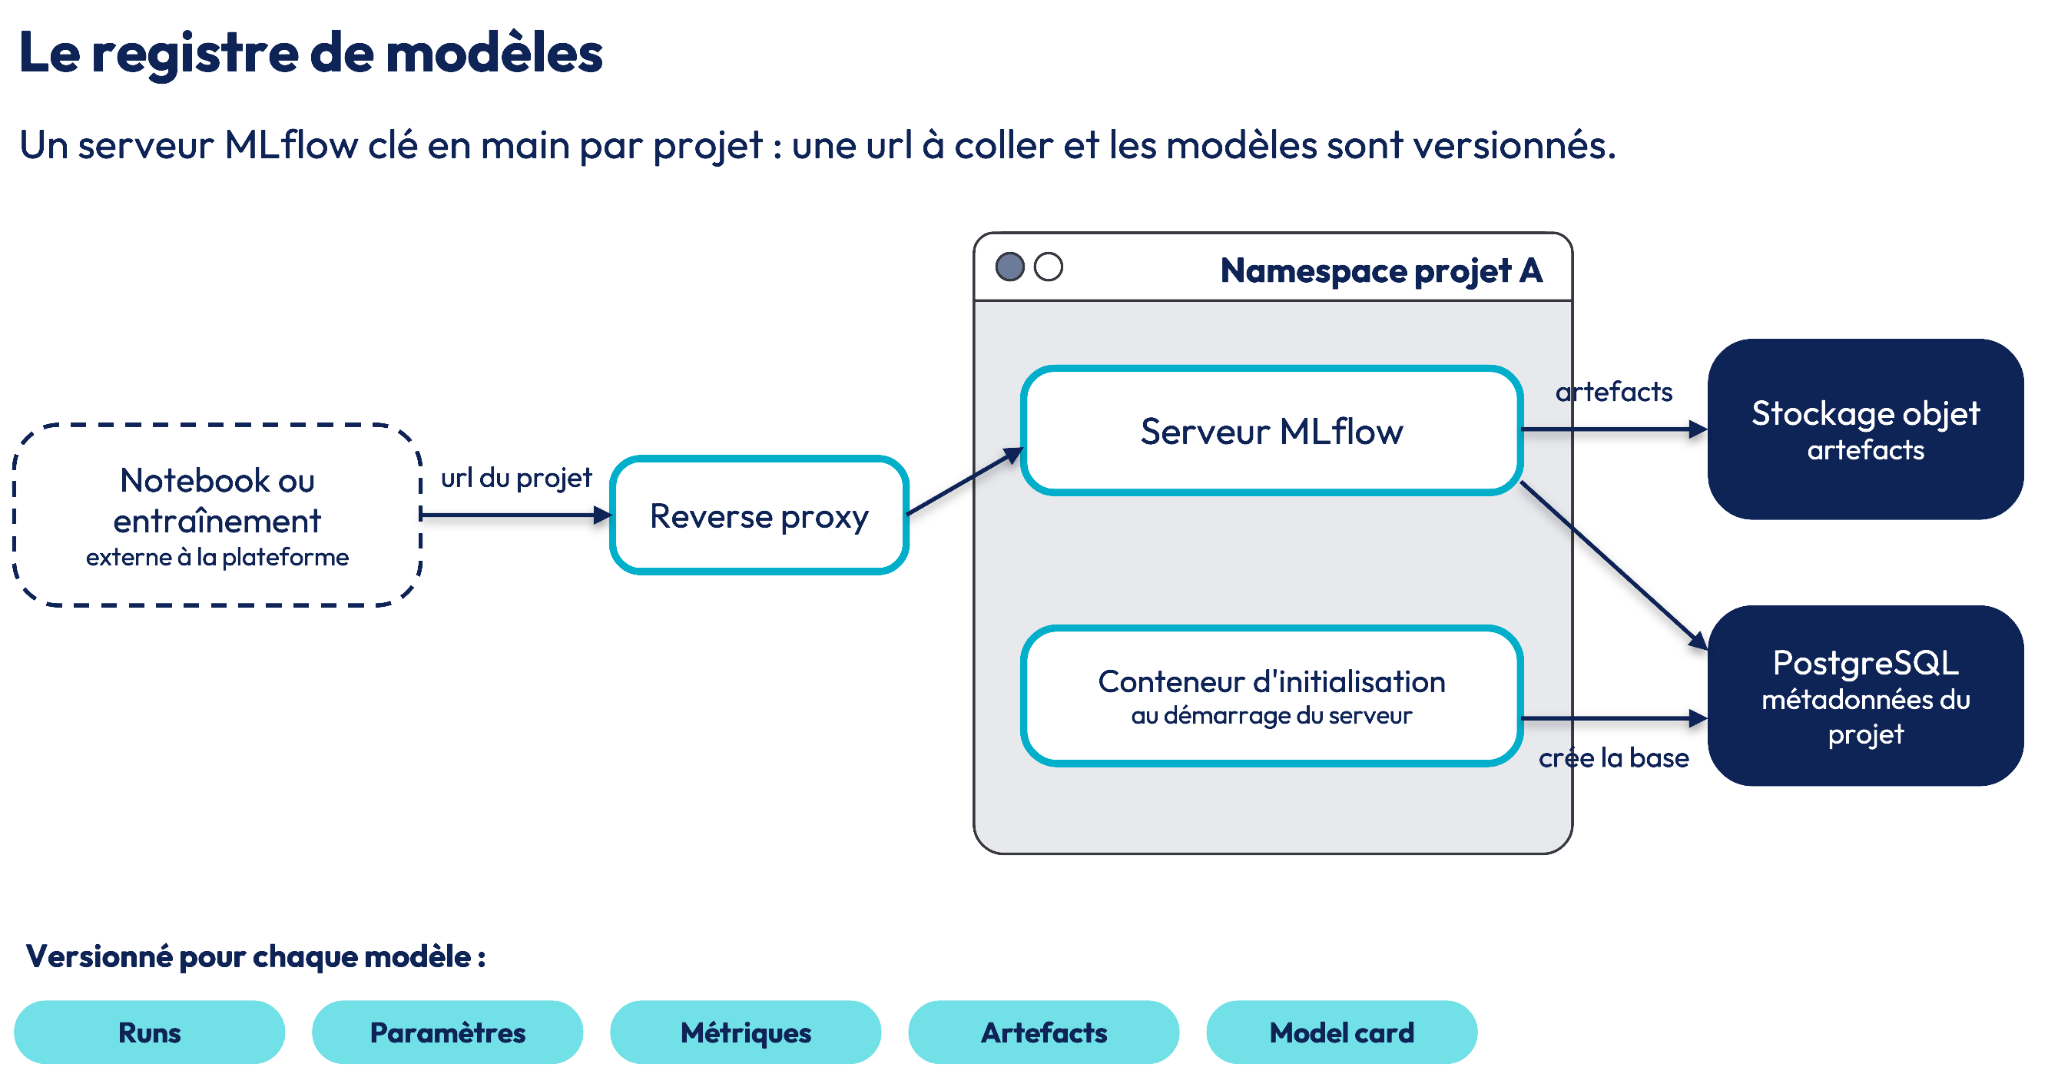
Côté Kubernetes, la création d'un projet déclenche celle de son namespace, dans lequel la plateforme déploie un serveur MLflow (un deployment et un service). Au démarrage, un conteneur d'initialisation crée la base de métadonnées du projet sur le serveur PostgreSQL. Le registre est ensuite accessible derrière le reverse proxy de la plateforme, sur une url propre au projet.
5.2 Le déploiement de modèles
Reprenons le modèle de paiement en 3 fois de notre introduction. Il a fallu une réunion, un ADR et quelques jours, voire quelques semaines, pour qu'il soit exposé sous forme d'API. La brique de déploiement a pour objectif de ramener cette étape à une seule action : choisir une version dans le registre du projet et la déployer.
Sous le capot, la plateforme télécharge les artefacts du modèle depuis le registre, construit une image Docker contenant le modèle et son environnement Python (les dépendances enregistrées avec le modèle dans MLflow), puis crée les ressources Kubernetes nécessaires dans le namespace du projet : le deployment, le service et la route qui permet d'appeler le modèle depuis l'extérieur du cluster. Le modèle est alors appelable derrière le reverse proxy de la plateforme, sur une url construite à partir du nom du projet et du nom du modèle. Le data scientist n'écrit aucun Dockerfile, aucune ligne de YAML, et n'a besoin d'aucun accès au cluster. Chaque déploiement (et chaque décomission) est inscrit dans le journal d'événements du projet, avec l'utilisateur qui en est à l'origine.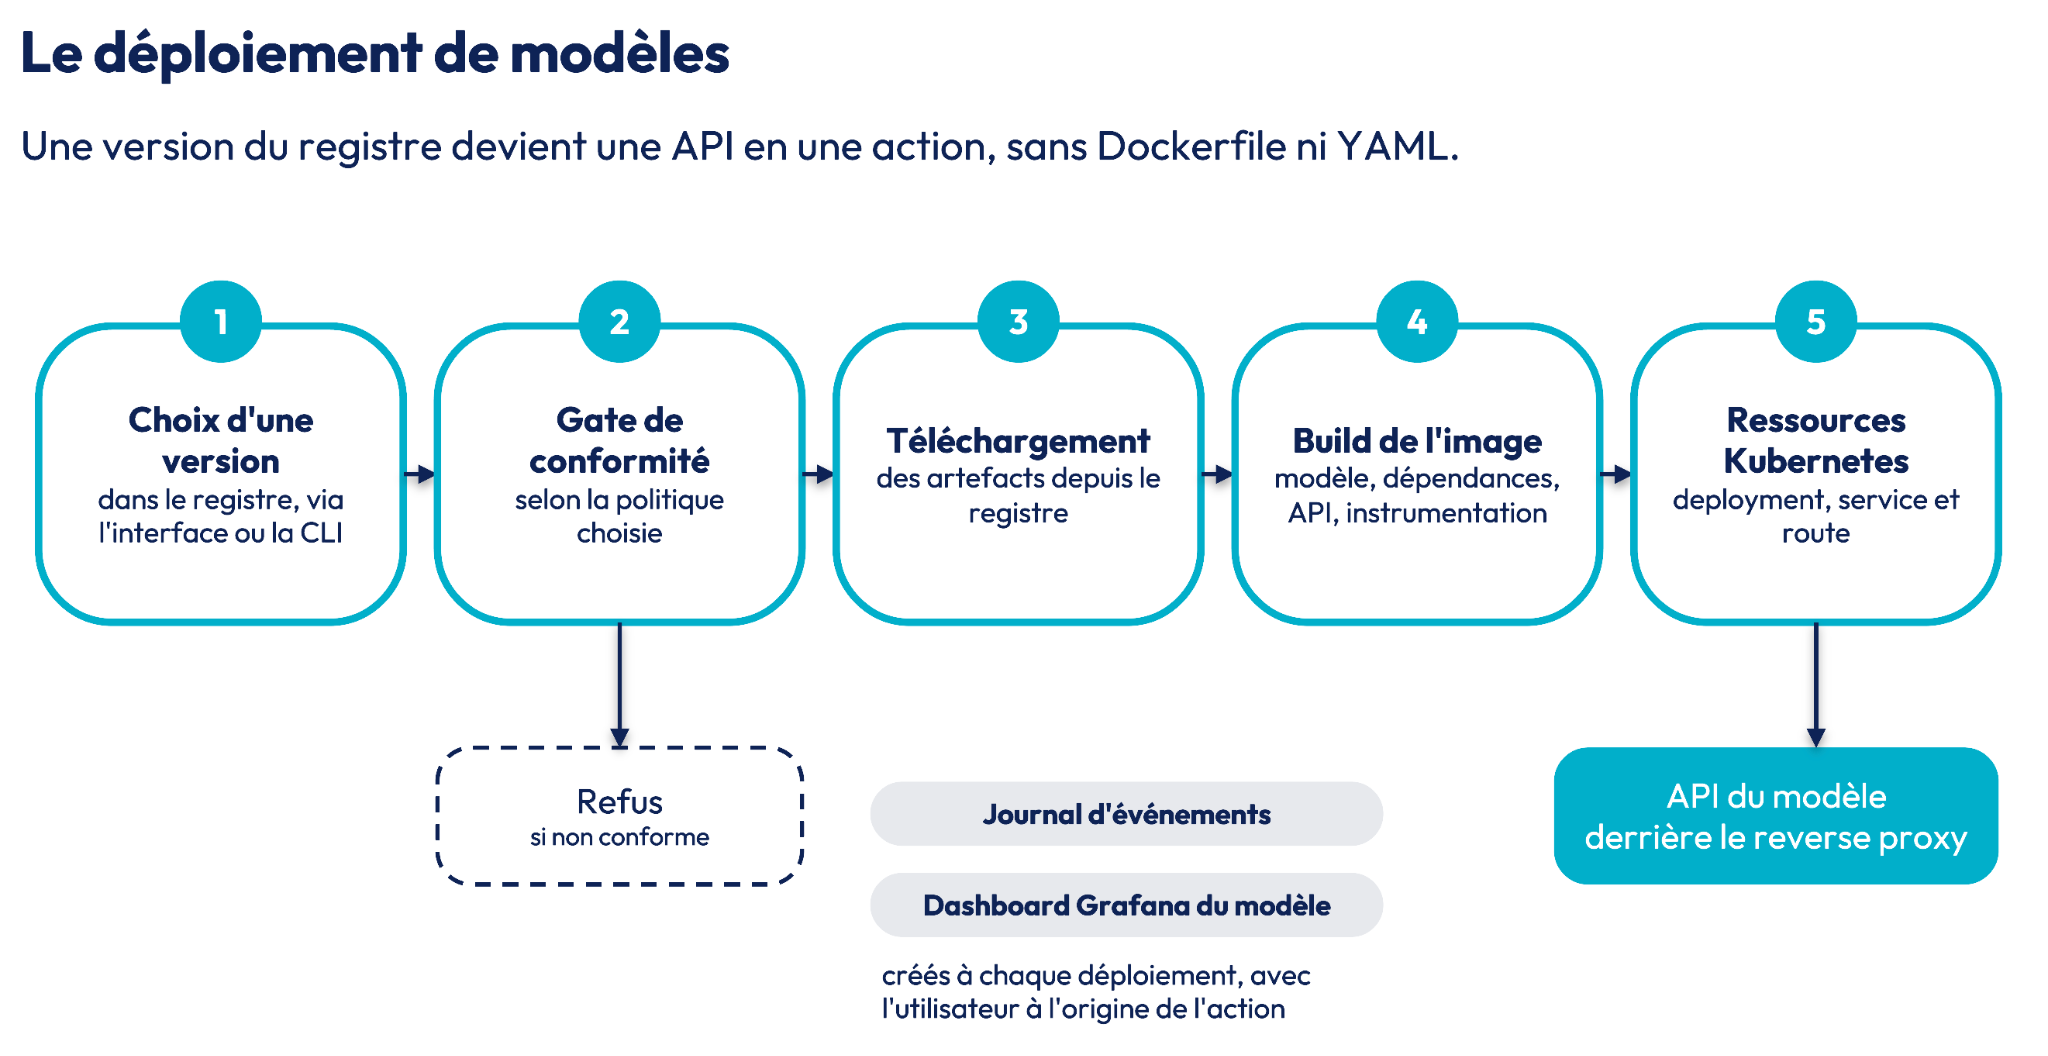
C'est aussi dans cette brique que la conformité peut bloquer une mise en production. Nous en reparlerons avec la gouvernance.
5.3 Le runner de modèles
Le runner, c'est ce qui tourne une fois le modèle déployé : le conteneur qui charge le modèle et répond aux demandes de prédiction. Plutôt que de laisser chaque équipe écrire sa propre API (avec ses conventions de nommage, de format et de gestion d'erreurs), la plateforme génère la même pour tous les modèles. Il s'agit d'une API FastAPI qui charge le modèle au format MLflow et expose trois routes : /predict pour la prédiction (en JSON ou par envoi de fichier), /health pour vérifier que le service répond, et /metrics pour le monitoring.
Une question que tout le monde s'est déjà posée : quel est le format exact du payload à envoyer au modèle ? Ici, l'API expose sa propre documentation Swagger, générée à partir de la signature du modèle (la description des colonnes d'entrée et de sortie) enregistrée dans le registre. Le contrat d'interface n'est plus une information qu'on se transmet oralement d'une équipe à l'autre, il découle directement du modèle.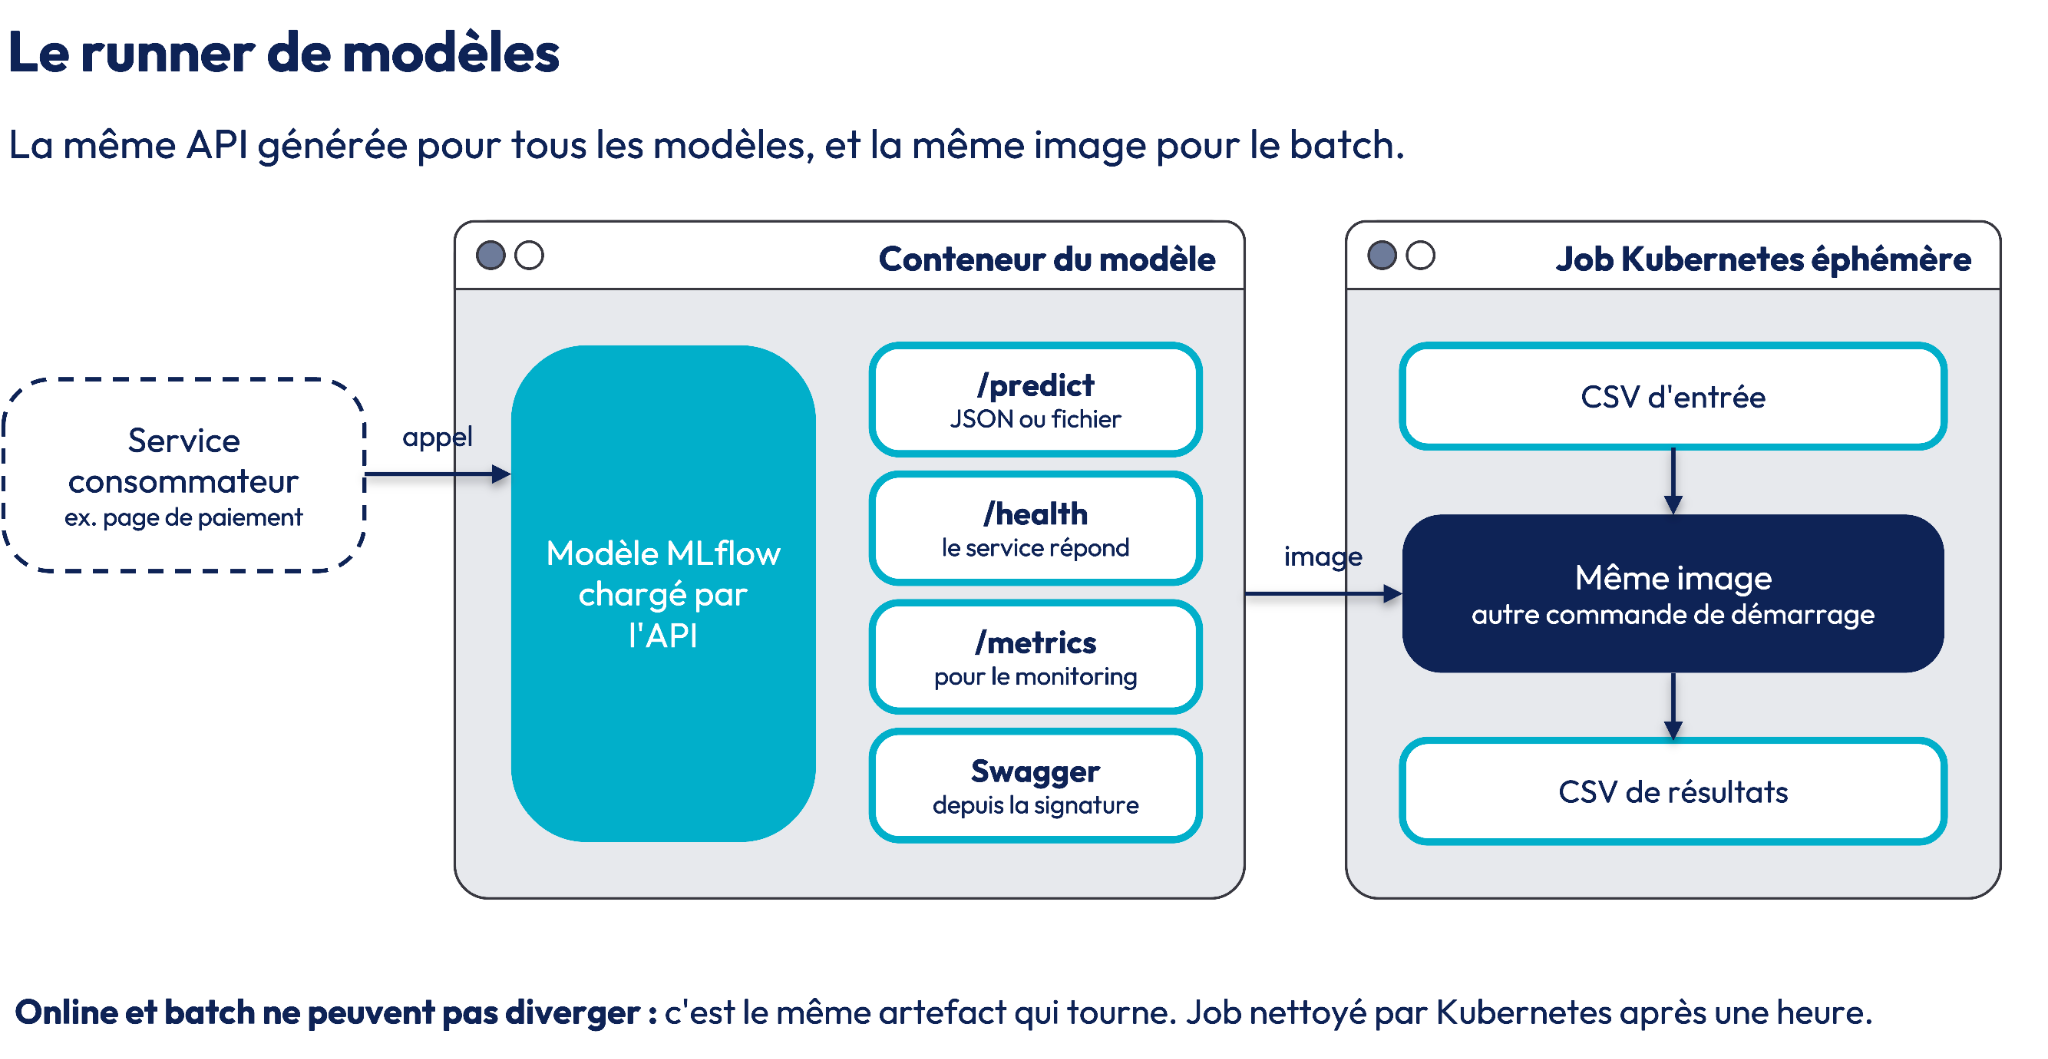
Le runner sait aussi faire des prédictions en batch. Un fichier CSV est déposé dans un espace de stockage (par exemple un bucket S3), un job Kubernetes éphémère est lancé avec l'image déjà construite pour le modèle déployé, et un fichier CSV de résultats est produit. Seule la commande de démarrage du conteneur change : au lieu de lancer l'API, il lit le fichier d'entrée, prédit et écrit le résultat dans le stockage objet. Le job est ensuite nettoyé automatiquement par Kubernetes au bout d'une heure. Le comportement online et le comportement batch ne peuvent donc pas diverger, puisque c'est le même artefact qui tourne !
5.4 Le monitoring de modèles
Dans notre histoire, l'API du modèle est tombée et il a fallu plusieurs jours (et une réunion avec le service des paiements) pour s'en rendre compte. Le monitoring et l’alerting sont les briques qui auraient dû donner l'alerte.
Dans notre plateforme, l'instrumentation n'est pas à la charge de l'équipe qui construit le modèle. Elle est injectée par la plateforme au moment de la construction de l'image : le conteneur tourne sous auto-instrumentation OpenTelemetry et expose ses métriques au format Prometheus. À chaque déploiement, la plateforme déclare le nouveau service à Prometheus via un ServiceMonitor (une ressource Kubernetes qui indique à Prometheus quel service interroger, et à quelle fréquence), et provisionne un dashboard Grafana dédié au modèle (volume d'appels, latence, erreurs). Personne n'a à y penser, personne ne peut l'oublier. Le fait d’avoir une instrumentation automatique pour le monitoring, assure une exhaustivité de la vue d’ensemble de la flotte: il n’y aura pas de modèle déployé qui n’est pas monitoré. Si l'instrumentation était optionnelle, la vue d'ensemble serait fausse.
Tous les modèles exposant les mêmes métriques, de la même façon, le parc devient comparable. Une vue de flotte, qui traverse tous les projets, donne un statut par modèle en fonction de son taux d'erreur : "healthy" sous 1 %, "caution" entre 1 et 5 %, "alert" au-delà. Comme nous l'avons vu dans la section 5, nous isolons ce qui s'exécute, mais nous centralisons ce qui s'observe (un seul Prometheus et un seul Grafana pour toute la plateforme). Il est possible d’ajouter d’autres métriques, comme par exemple les émissions de CO2 en intégrant codecarbon dans chaque déploiement.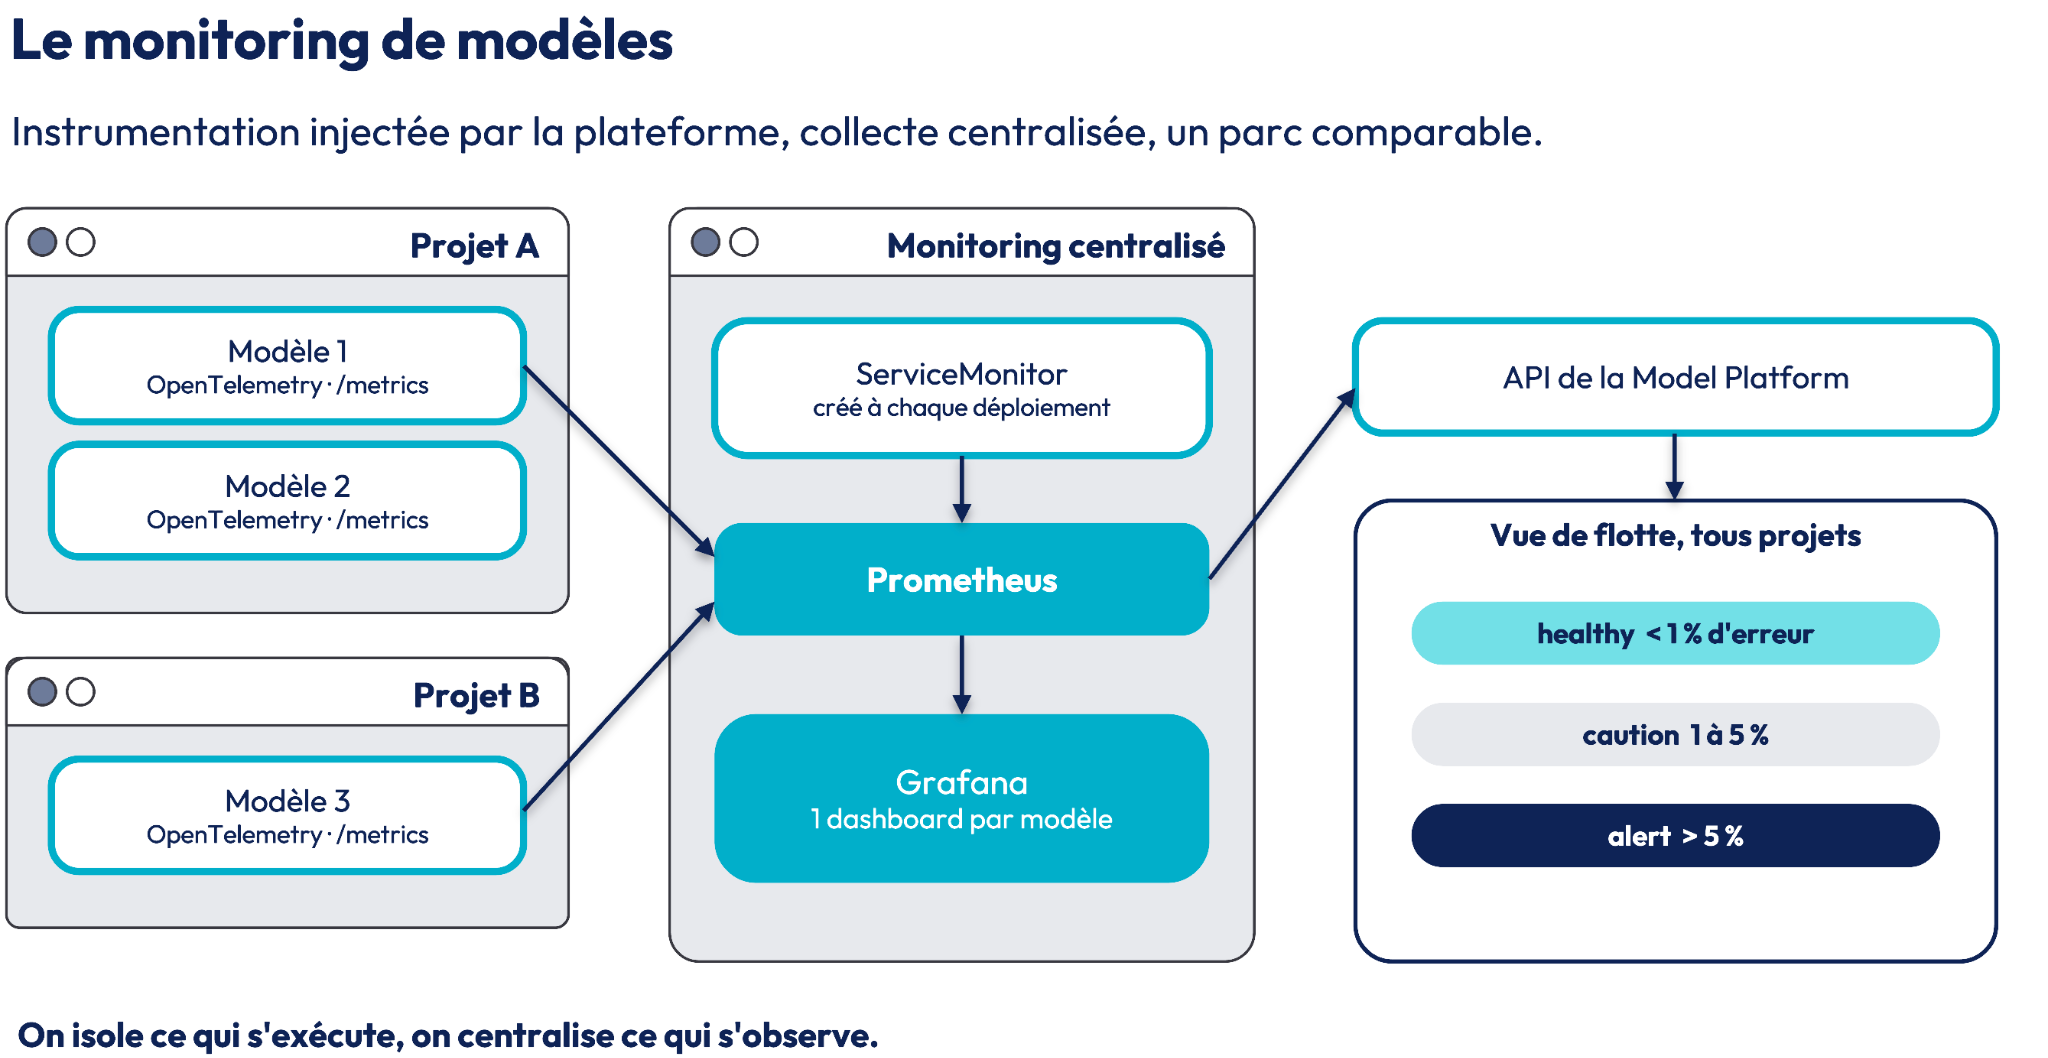
Précisons dès maintenant que ce monitoring est opérationnel : il ne dit rien, pour l'instant, de la dérive des données ou de la performance du modèle. Nous en reparlerons plus loin.
5.5 La gouvernance de modèles
Pour rappel, dans notre cas imaginaire, la CNIL vous demandait, pour tous vos modèles en production, les données d'apprentissage, les métriques, la gestion des risques, les logs et bien d'autres informations, et vous ne pouviez en fournir qu'une partie. La gouvernance est la brique qui rassemble ces informations, pour tous les modèles de tous les projets, au même endroit.
Elle lit les métadonnées de chaque registre de projet et le journal d'événements, et génère à partir d'eux une fiche de conformité AI Act par version de modèle. Chaque section de la fiche (classification du risque, documentation technique, données d'entraînement, contrôle humain, traçabilité, etc.) est rattachée à un article du règlement. Une documentation rédigée à la main est juste le jour où elle est écrite, et fausse trois versions de modèle plus tard. Ici, elle ne peut pas diverger du modèle réel, puisqu'elle en est dérivée.
La conformité de chaque modèle est évaluée de deux façons. Une évaluation déterministe vérifie des critères obligatoires sans ambiguïté possible : niveau de risque renseigné, model card présente, au moins une métrique, auteur identifié. Une revue par un LLM note ensuite la complétude de la fiche et propose un plan d'actions priorisé. La première ne juge que la présence des informations, la seconde leur qualité.
Ces deux évaluations alimentent une gate de déploiement, configurable selon 3 politiques : désactivée, permissive (l'une des deux évaluations doit passer) ou stricte (les deux doivent passer). En mode strict, un modèle non conforme ne part tout simplement pas en production. La conformité cesse d'être un rapport produit après coup pour devenir un contrôle sur le chemin du déploiement.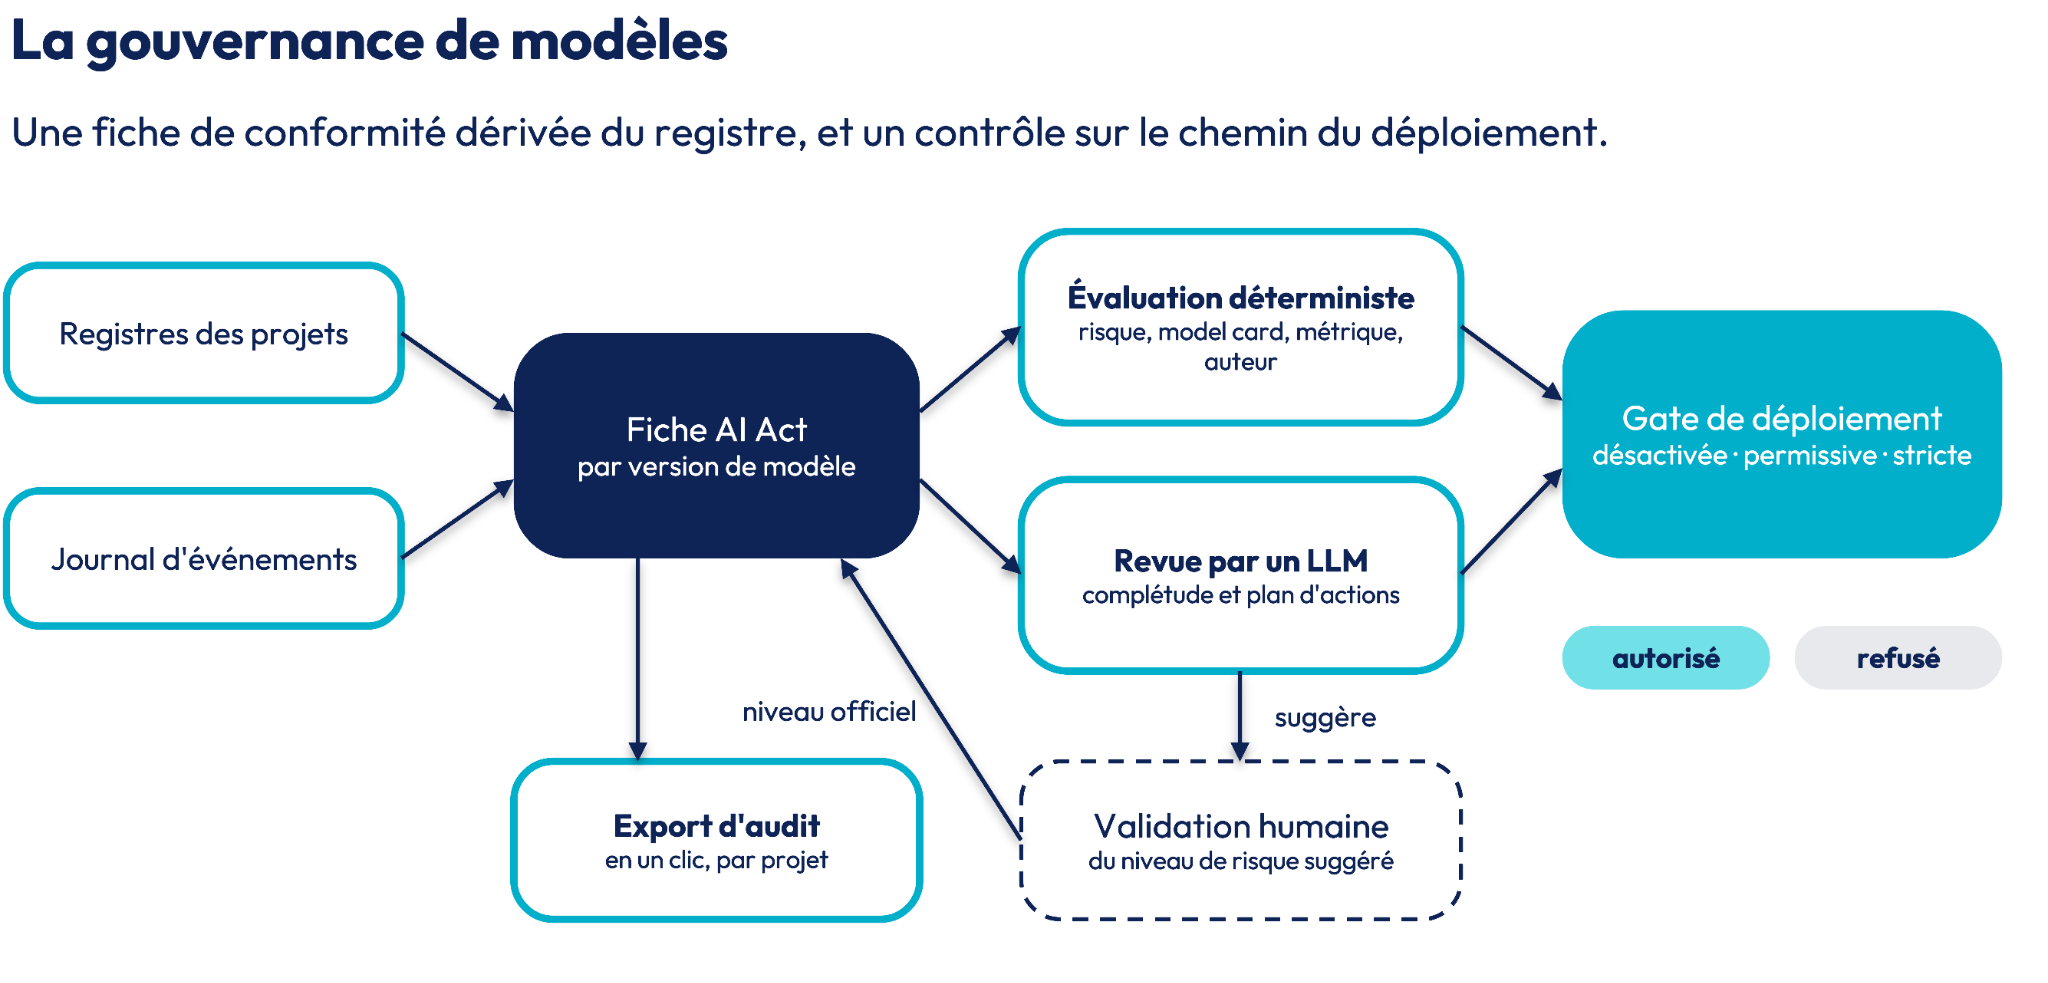
Le LLM peut aussi suggérer un niveau de risque AI Act pour un modèle, avec sa justification. Mais il ne s'agit que d'une suggestion : un humain doit l'accepter pour qu'elle devienne officielle. La responsabilité réglementaire ne se délègue pas à une IA. Enfin, un export d'audit permet de récupérer en un clic, pour un projet, les artefacts des modèles, leurs informations de gouvernance et le journal des événements.
6 - Démo
Reprenons notre head of data et son modèle de paiement en 3 fois, cette fois avec le model platform.
Première étape, la connexion. Chaque utilisateur dispose de son compte, et ses droits sont attribués projet par projet (viewer, developer, maintainer ou admin).
Page de connexion de la model platform : 
Figure 10 : La page de connexion.
Tout commence par la création du projet. Un nom, un responsable etc … et la plateforme provisionne le namespace et le serveur MLflow du projet.
Fenêtre de création du projet Paiement-3x-Scoring dans la model platform :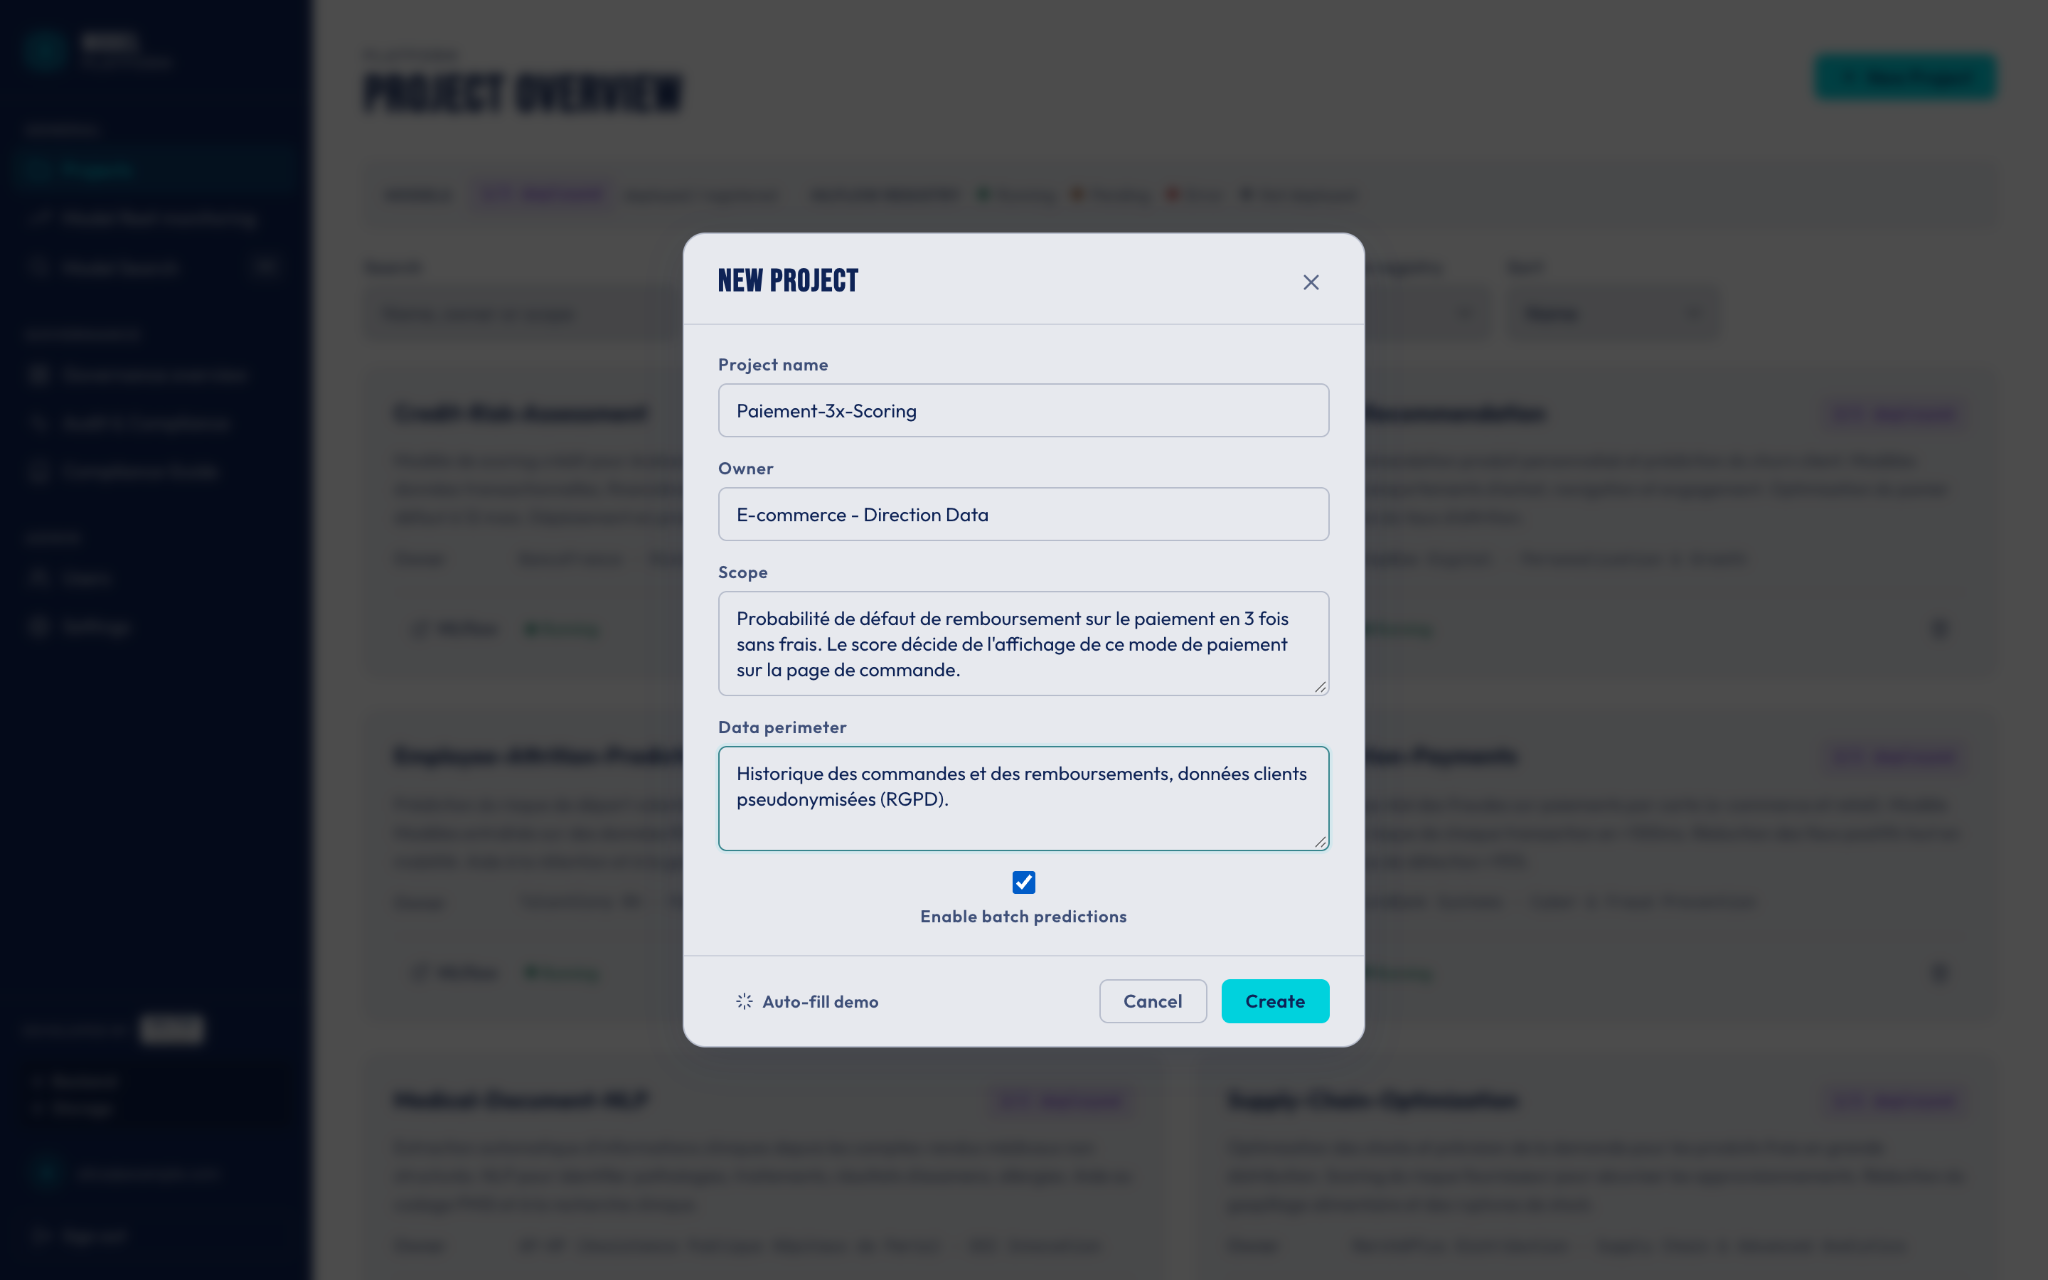
Le data scientist colle l'url du registre dans son notebook et entraîne son modèle. Celui-ci apparaît aussitôt dans le projet, avec sa version et ses statuts de conformité.
Liste des modèles du registre MLflow du projet, avec la version à déployer et les statuts de conformité : 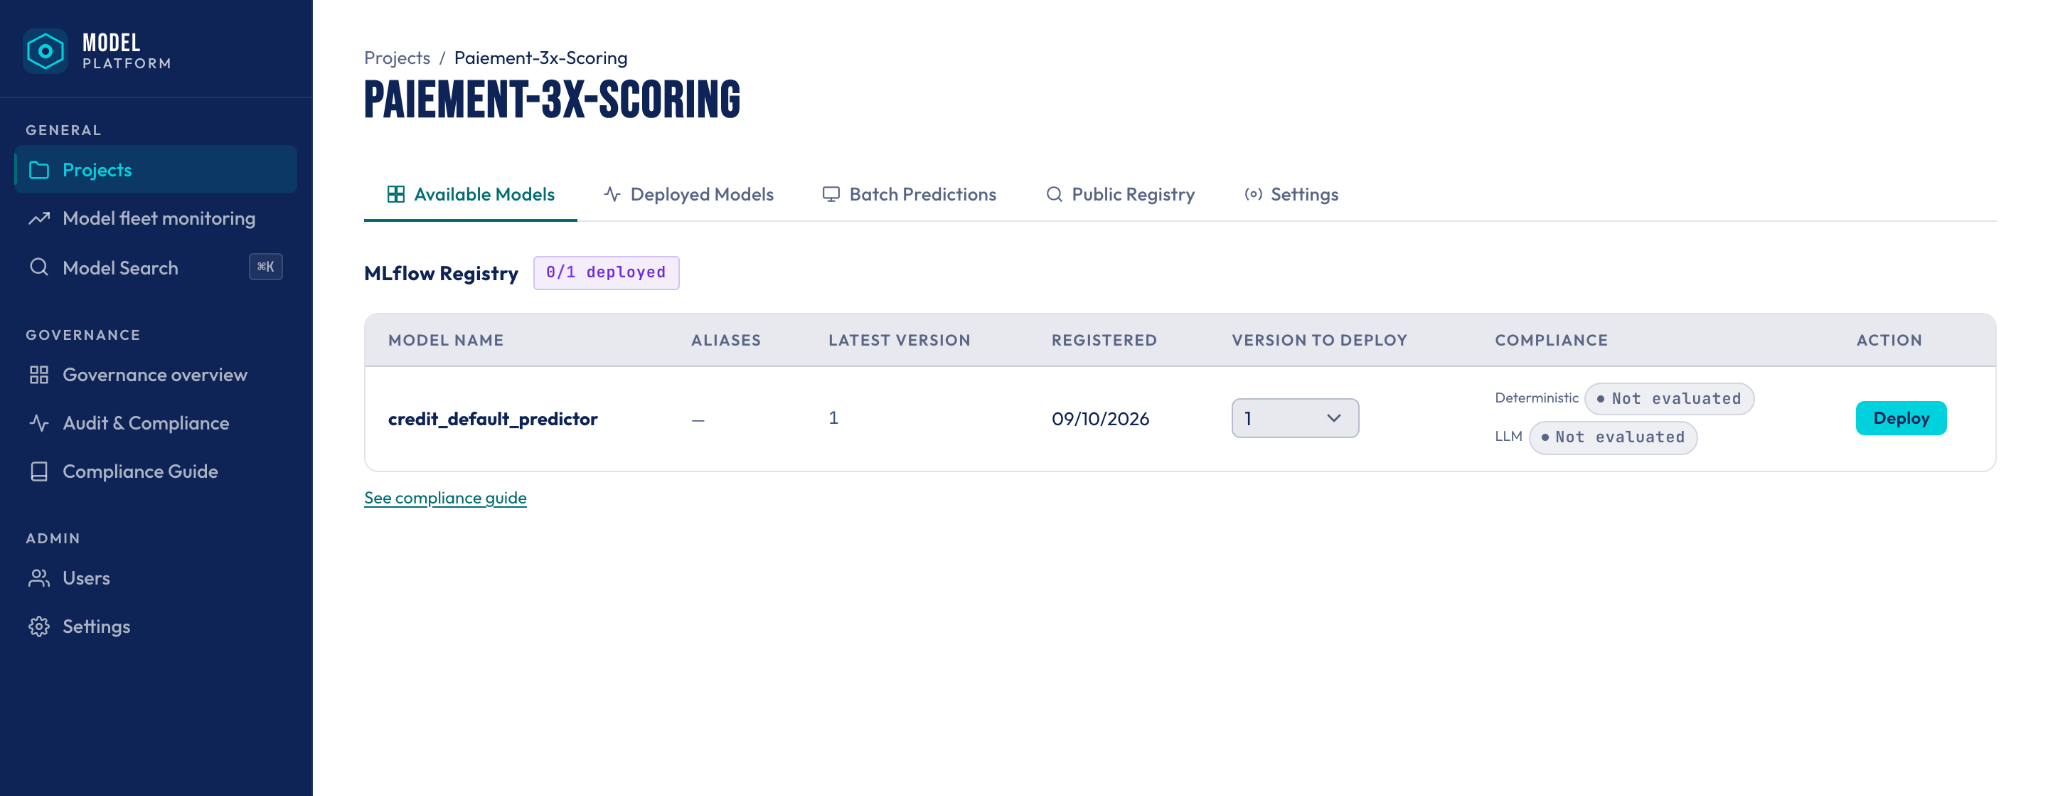
Figure 12 : Le modèle dans le registre du projet.
Un clic sur "Deploy", et le modèle est servi derrière le reverse proxy de la plateforme, avec sa documentation d'API et son dashboard Grafana. Plus besoin d'une réunion et d'un ADR pour décider comment l'exposer !
Onglet des modèles déployés, avec l'url de l'endpoint, le statut Running et les liens vers la documentation et le dashboard :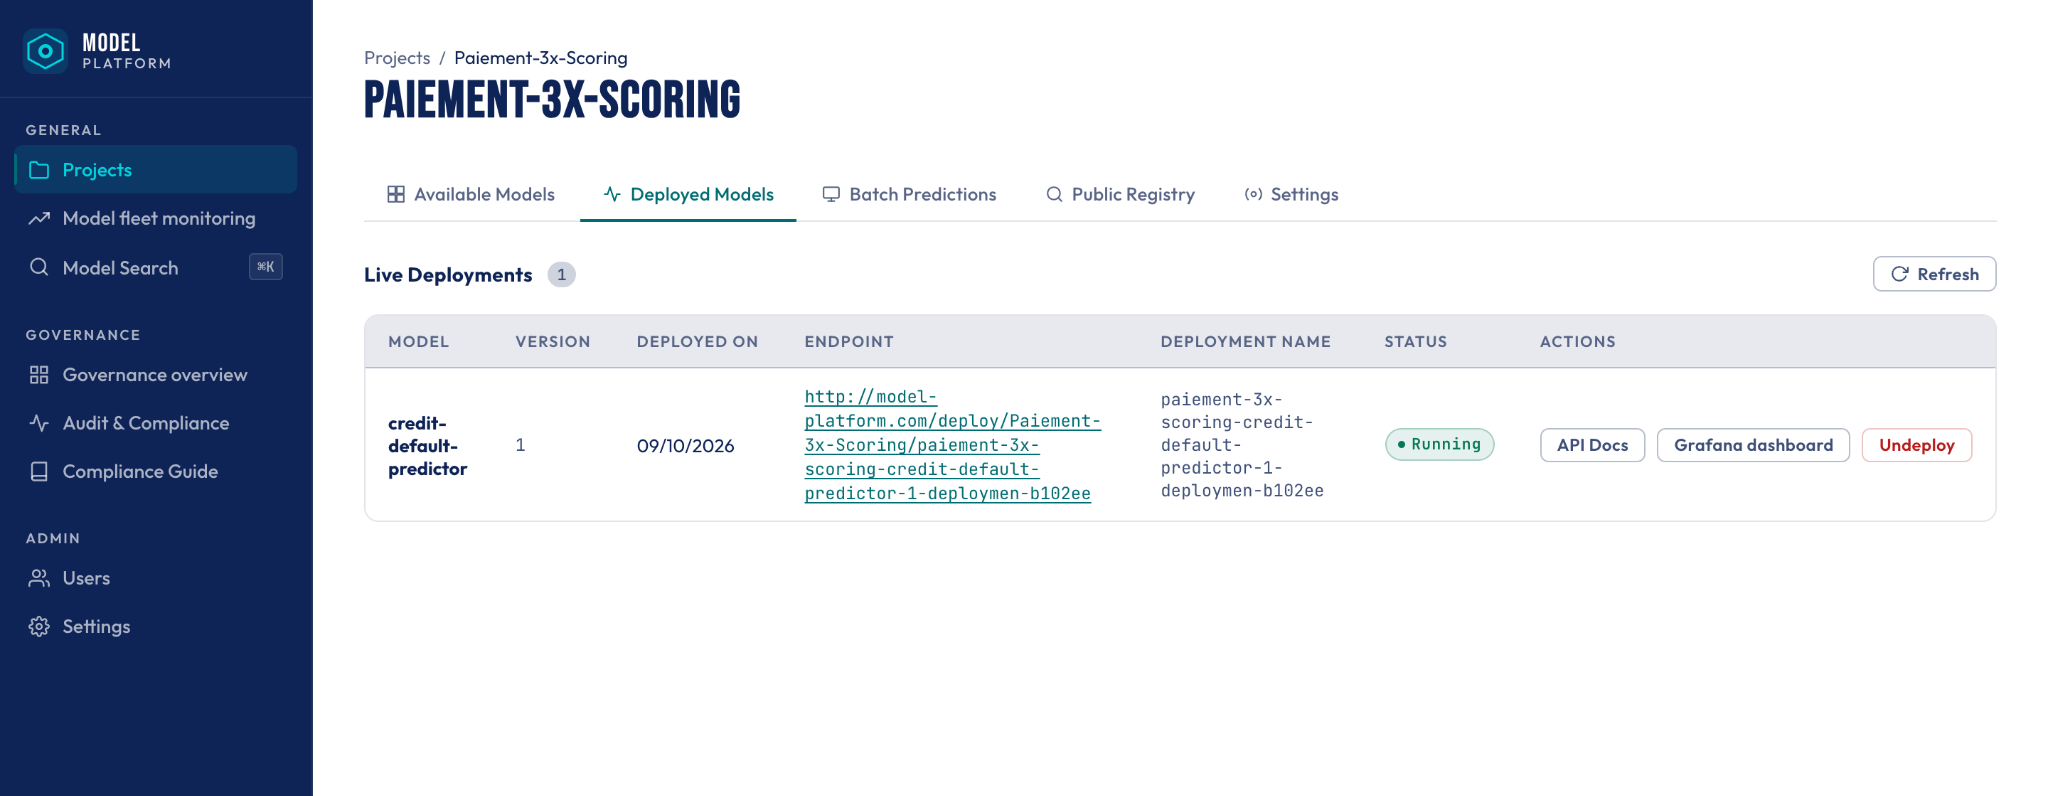
Documentation Swagger générée pour l'API du modèle, avec les routes /predict, /health et /metrics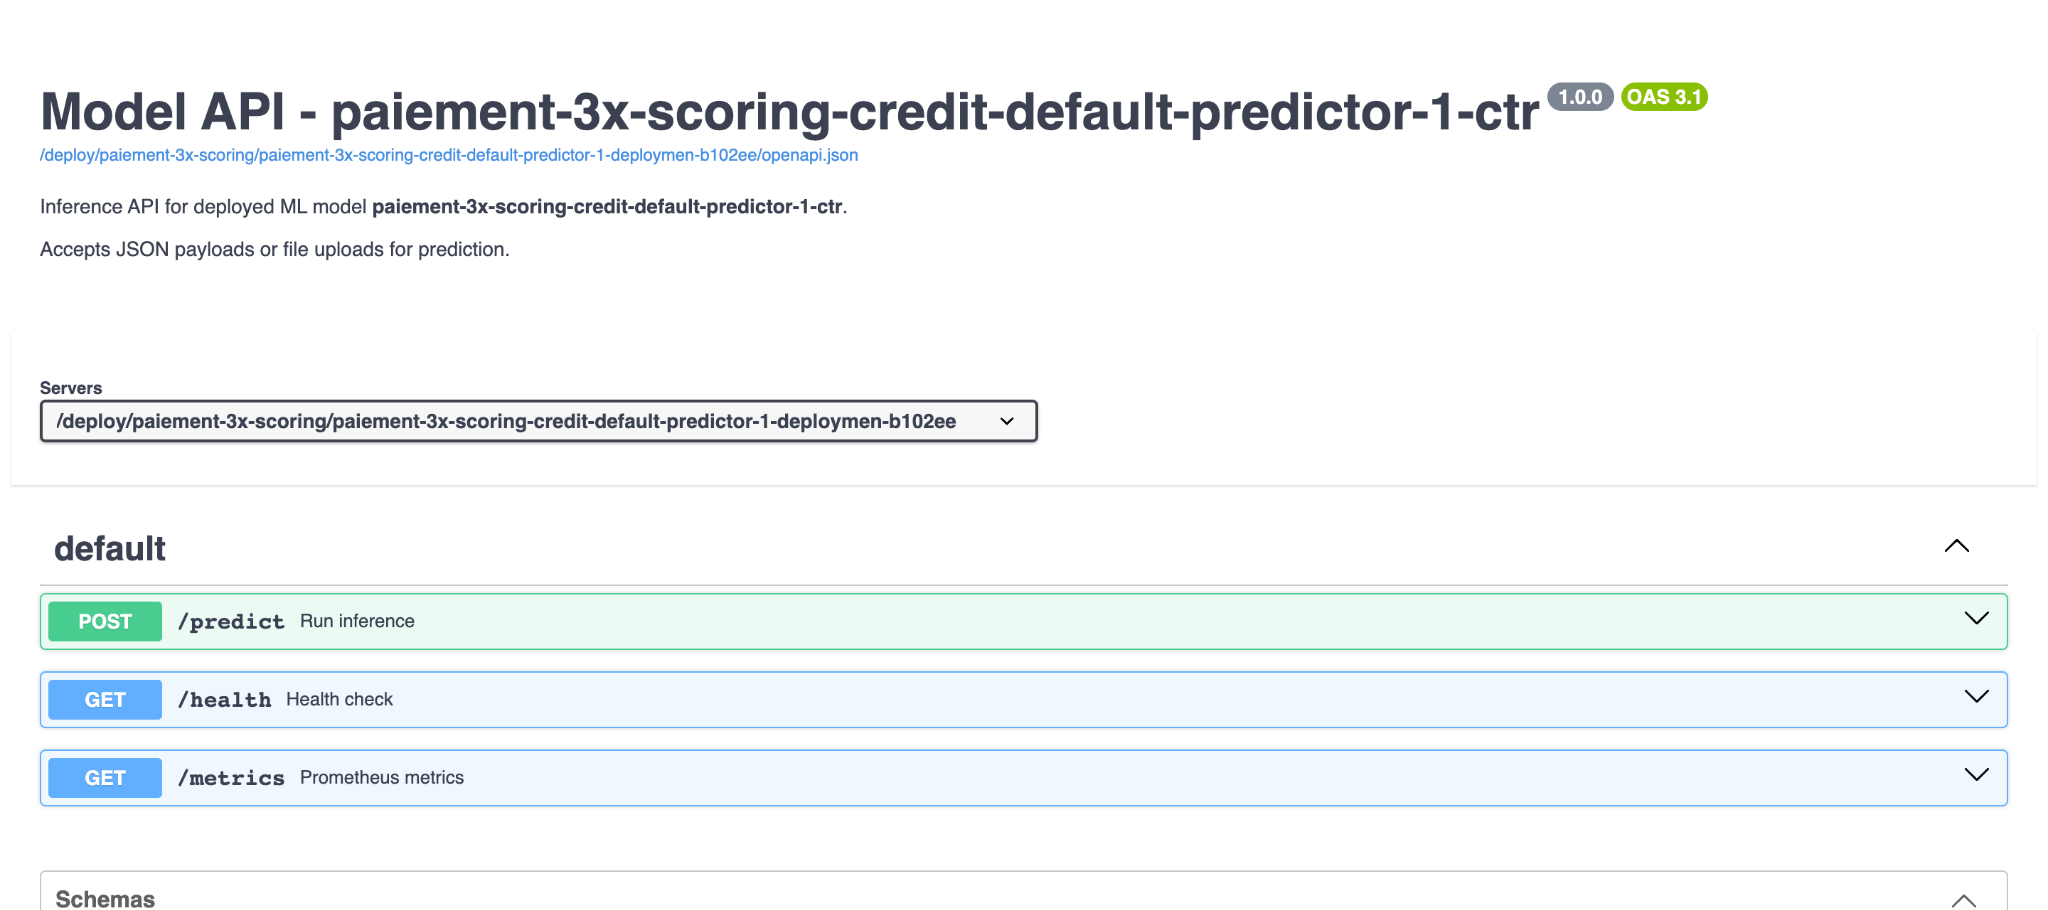
Quelques mois plus tard, le modèle se met à renvoyer des erreurs (ici simulées, environ 16 % des appels échouent). Cette fois, personne n'attend la réunion du service des paiements : la vue de flotte passe le modèle en "alert" dès que son taux d'erreur dépasse 5 %.
Vue de flotte de la plateforme : le modèle du projet Paiement-3x-Scoring est en alerte, les autres projets sont sains :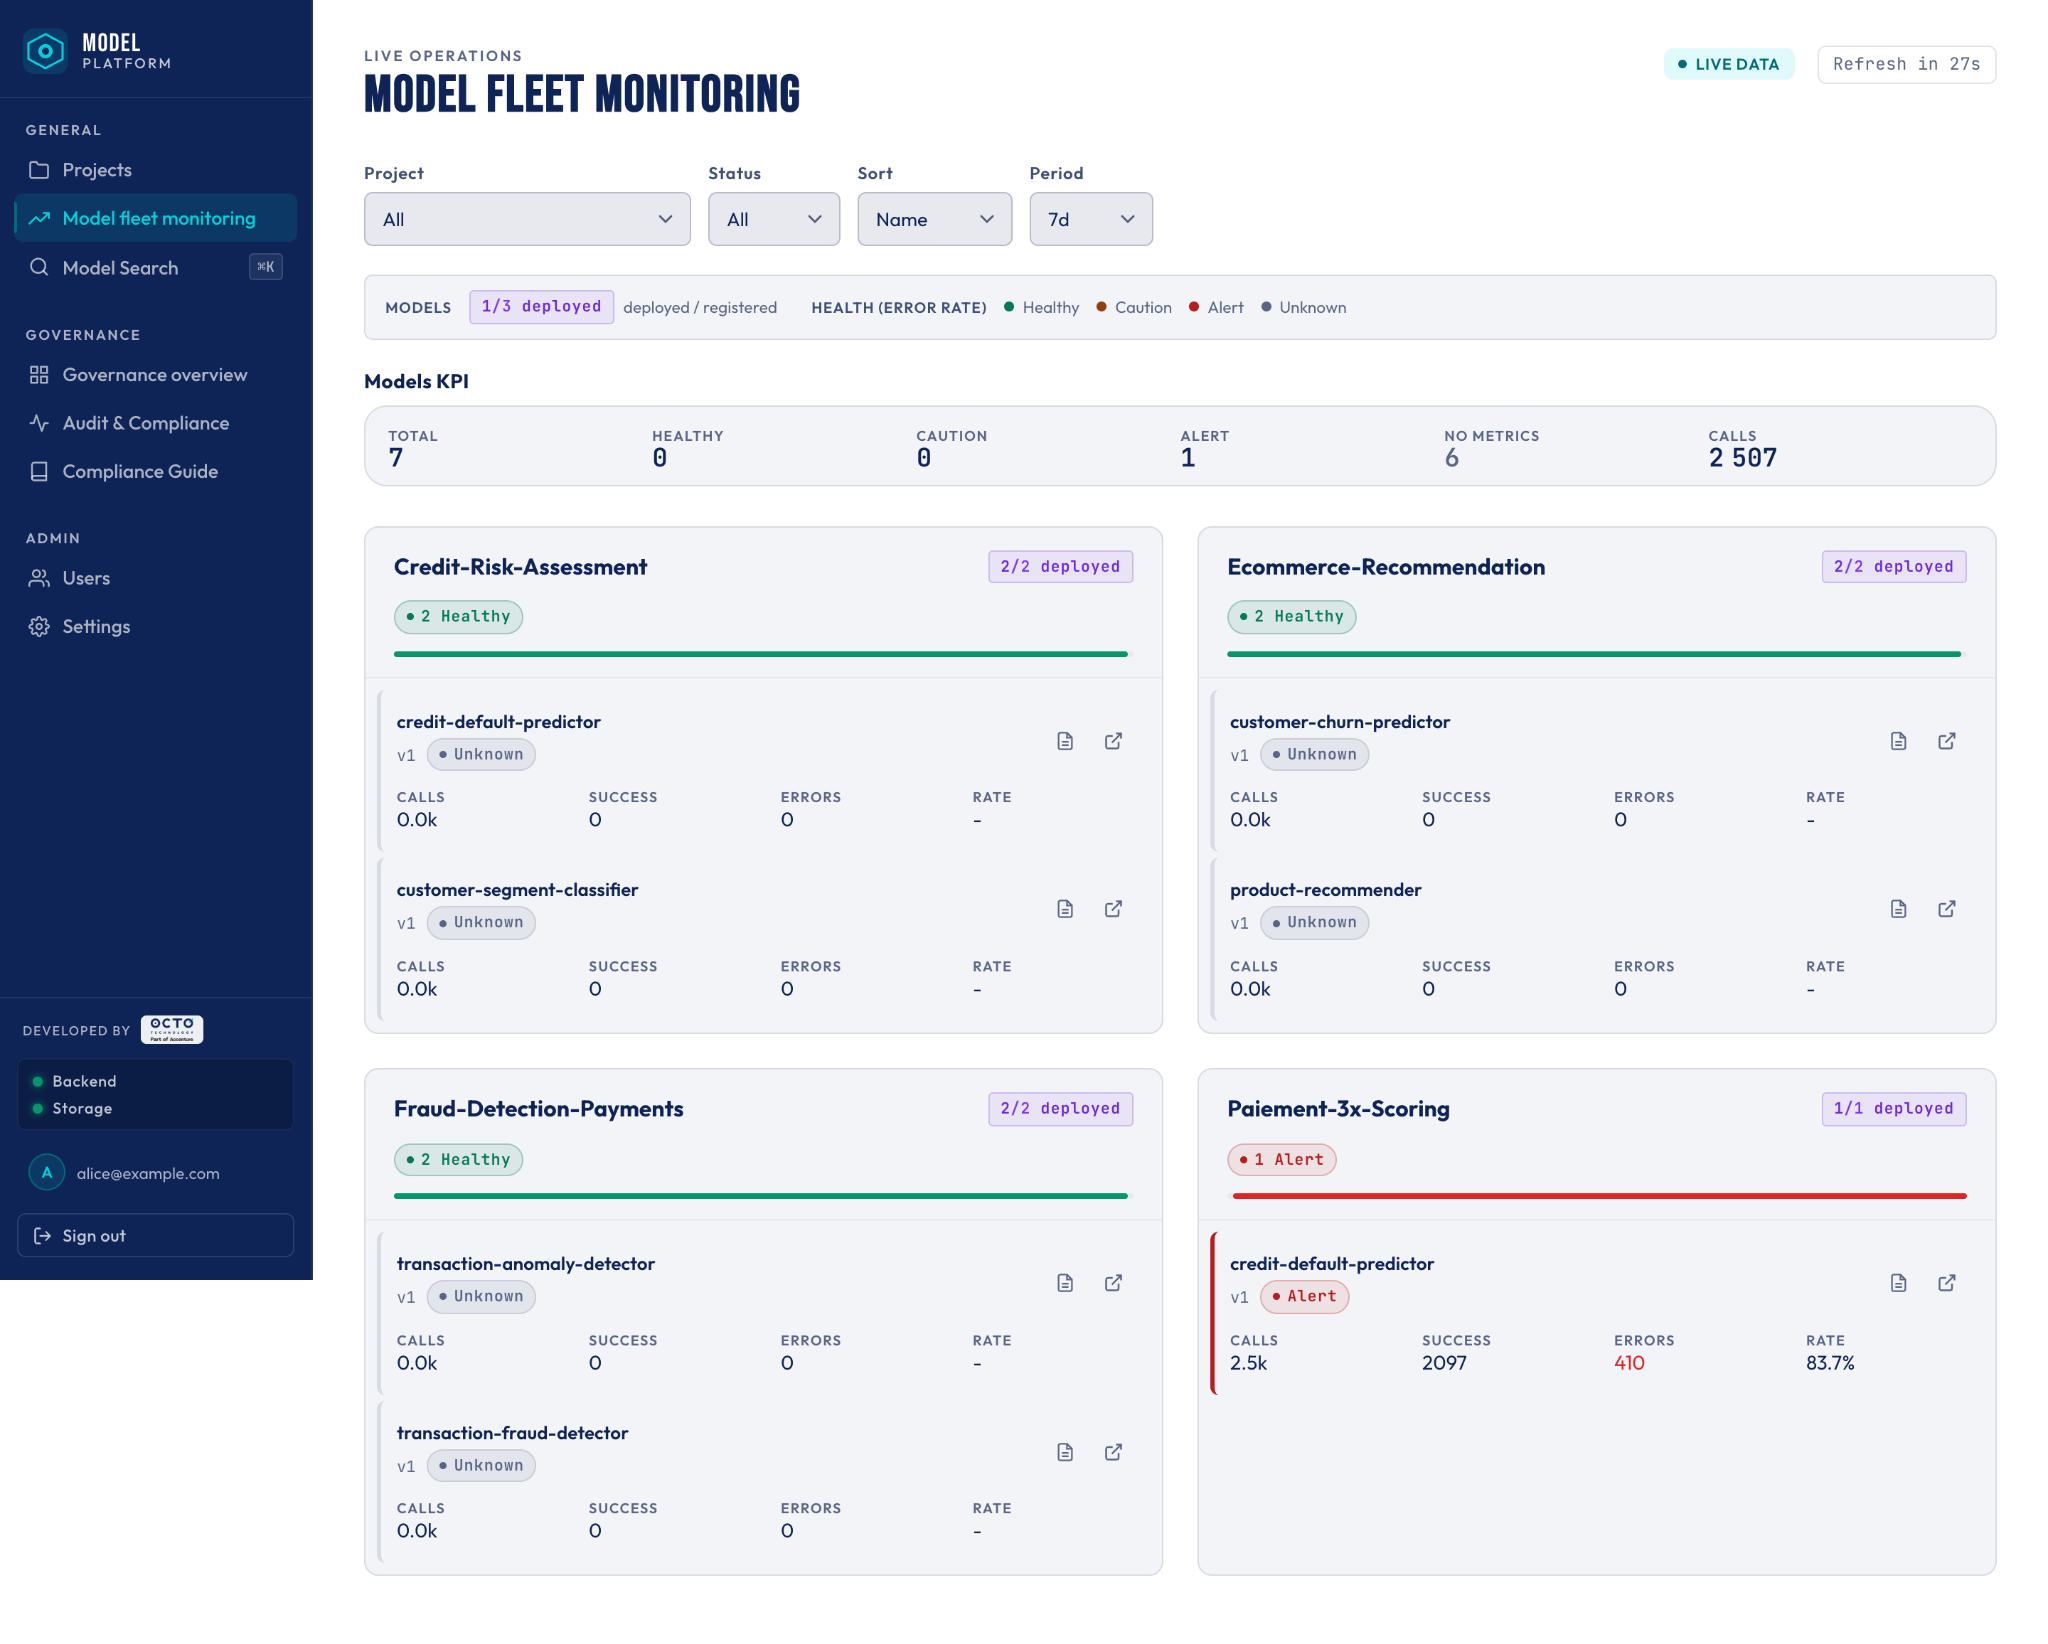
Pour chaque version de chaque modèle du parc, la plateforme a déjà renseigné le niveau de risque, l'évaluation déterministe et la revue par un LLM. Le dashboard de gouvernance en donne la vue d'ensemble : répartition des niveaux de risque, taux de conformité, et projet par projet ce qui reste à compléter.
Dashboard de gouvernance : nombre de projets et de modèles, politique de gate stricte, répartition des risques, conformité déterministe et LLM, matrice de conformité par projet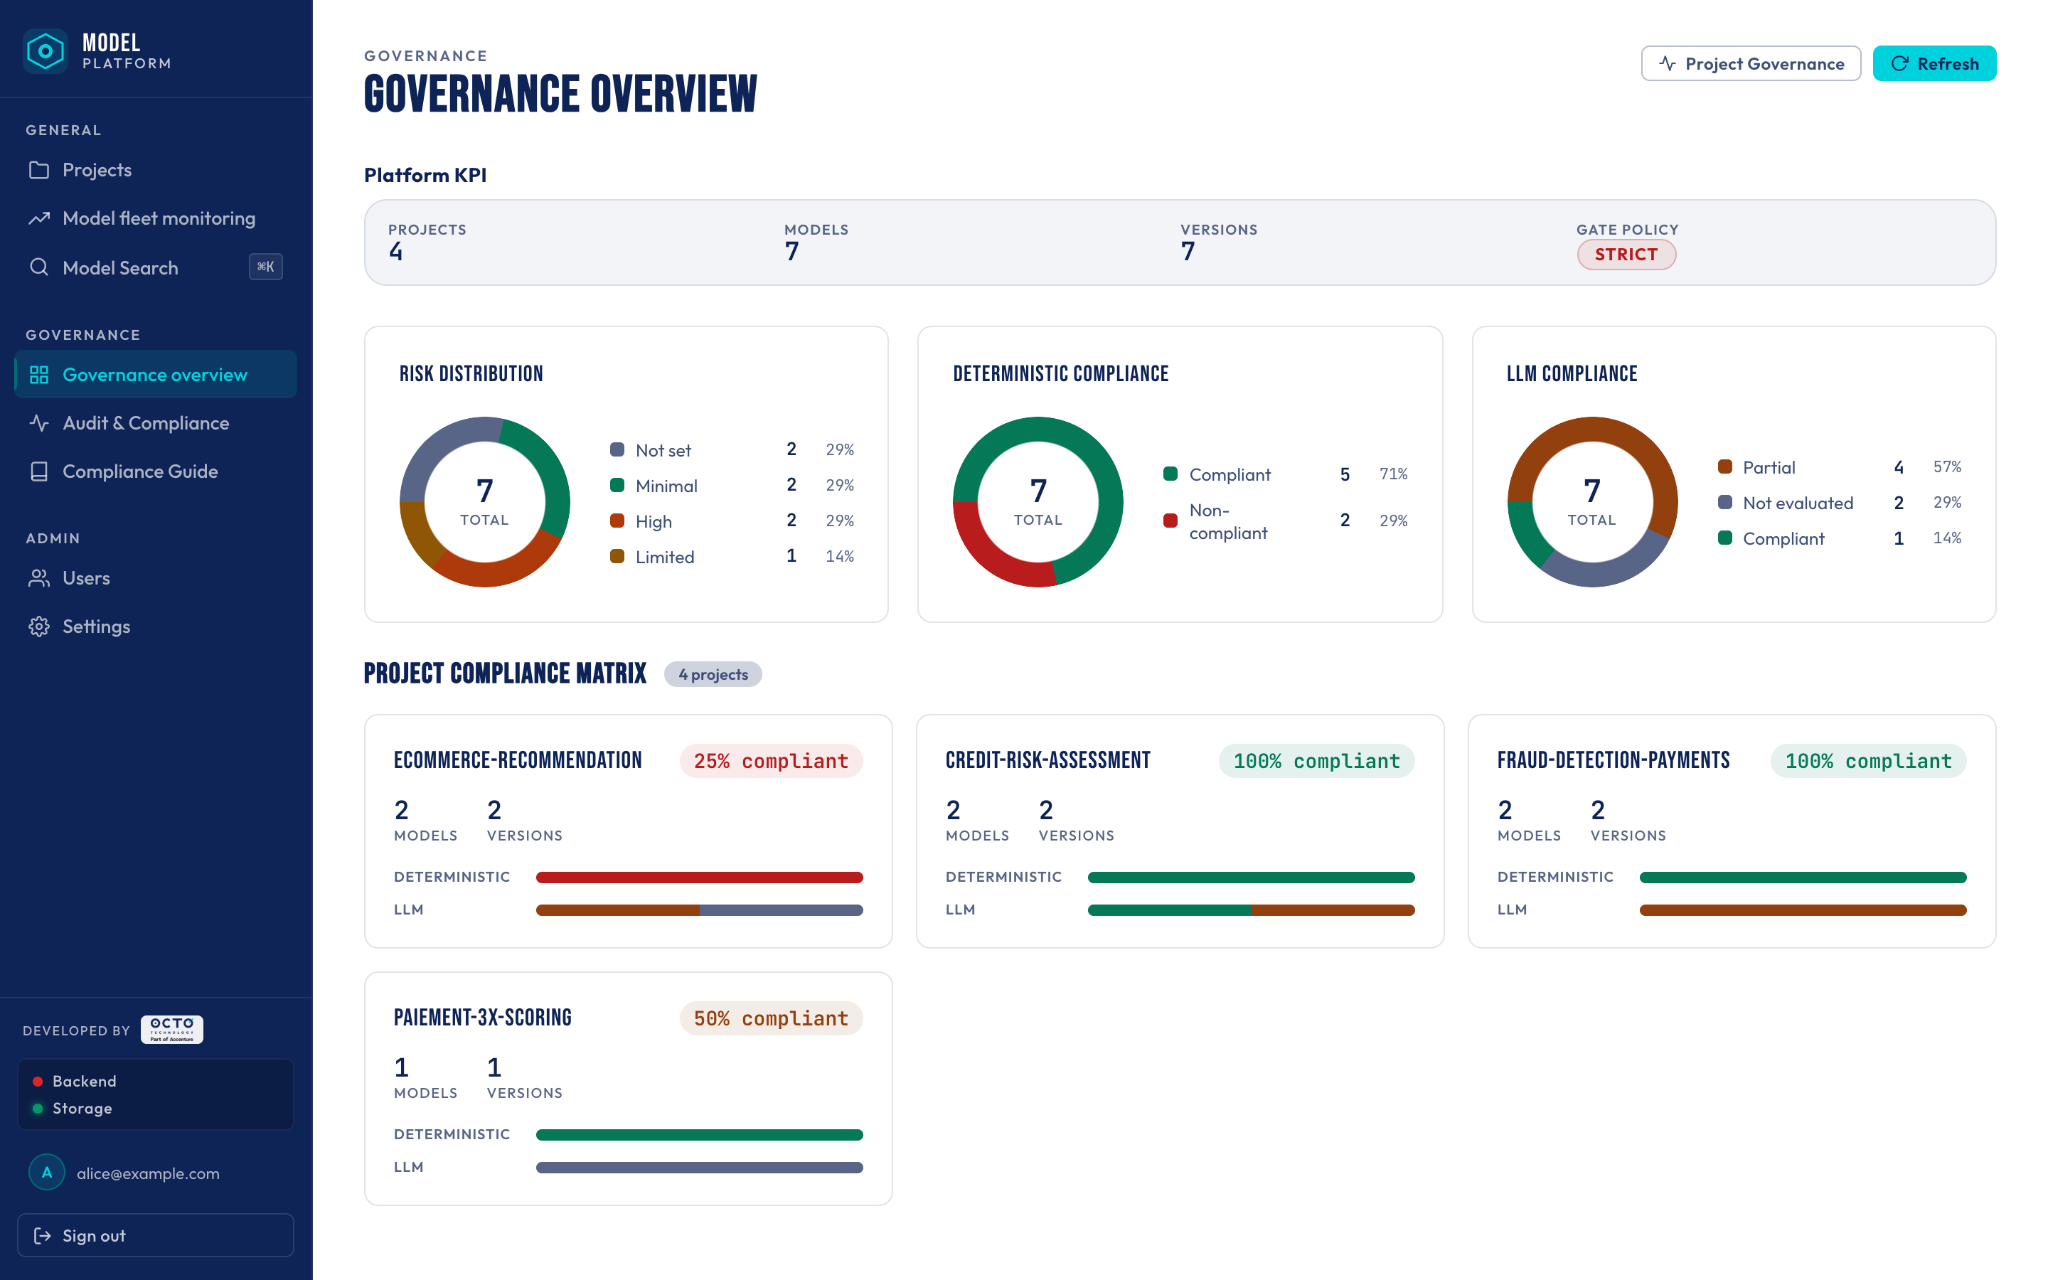
Mieux, en mode strict, une version dont la revue n'a pas été faite ne part tout simplement pas en production.
Refus de déploiement par la gate de conformité en mode strict, la revue LLM n'ayant pas été réalisée: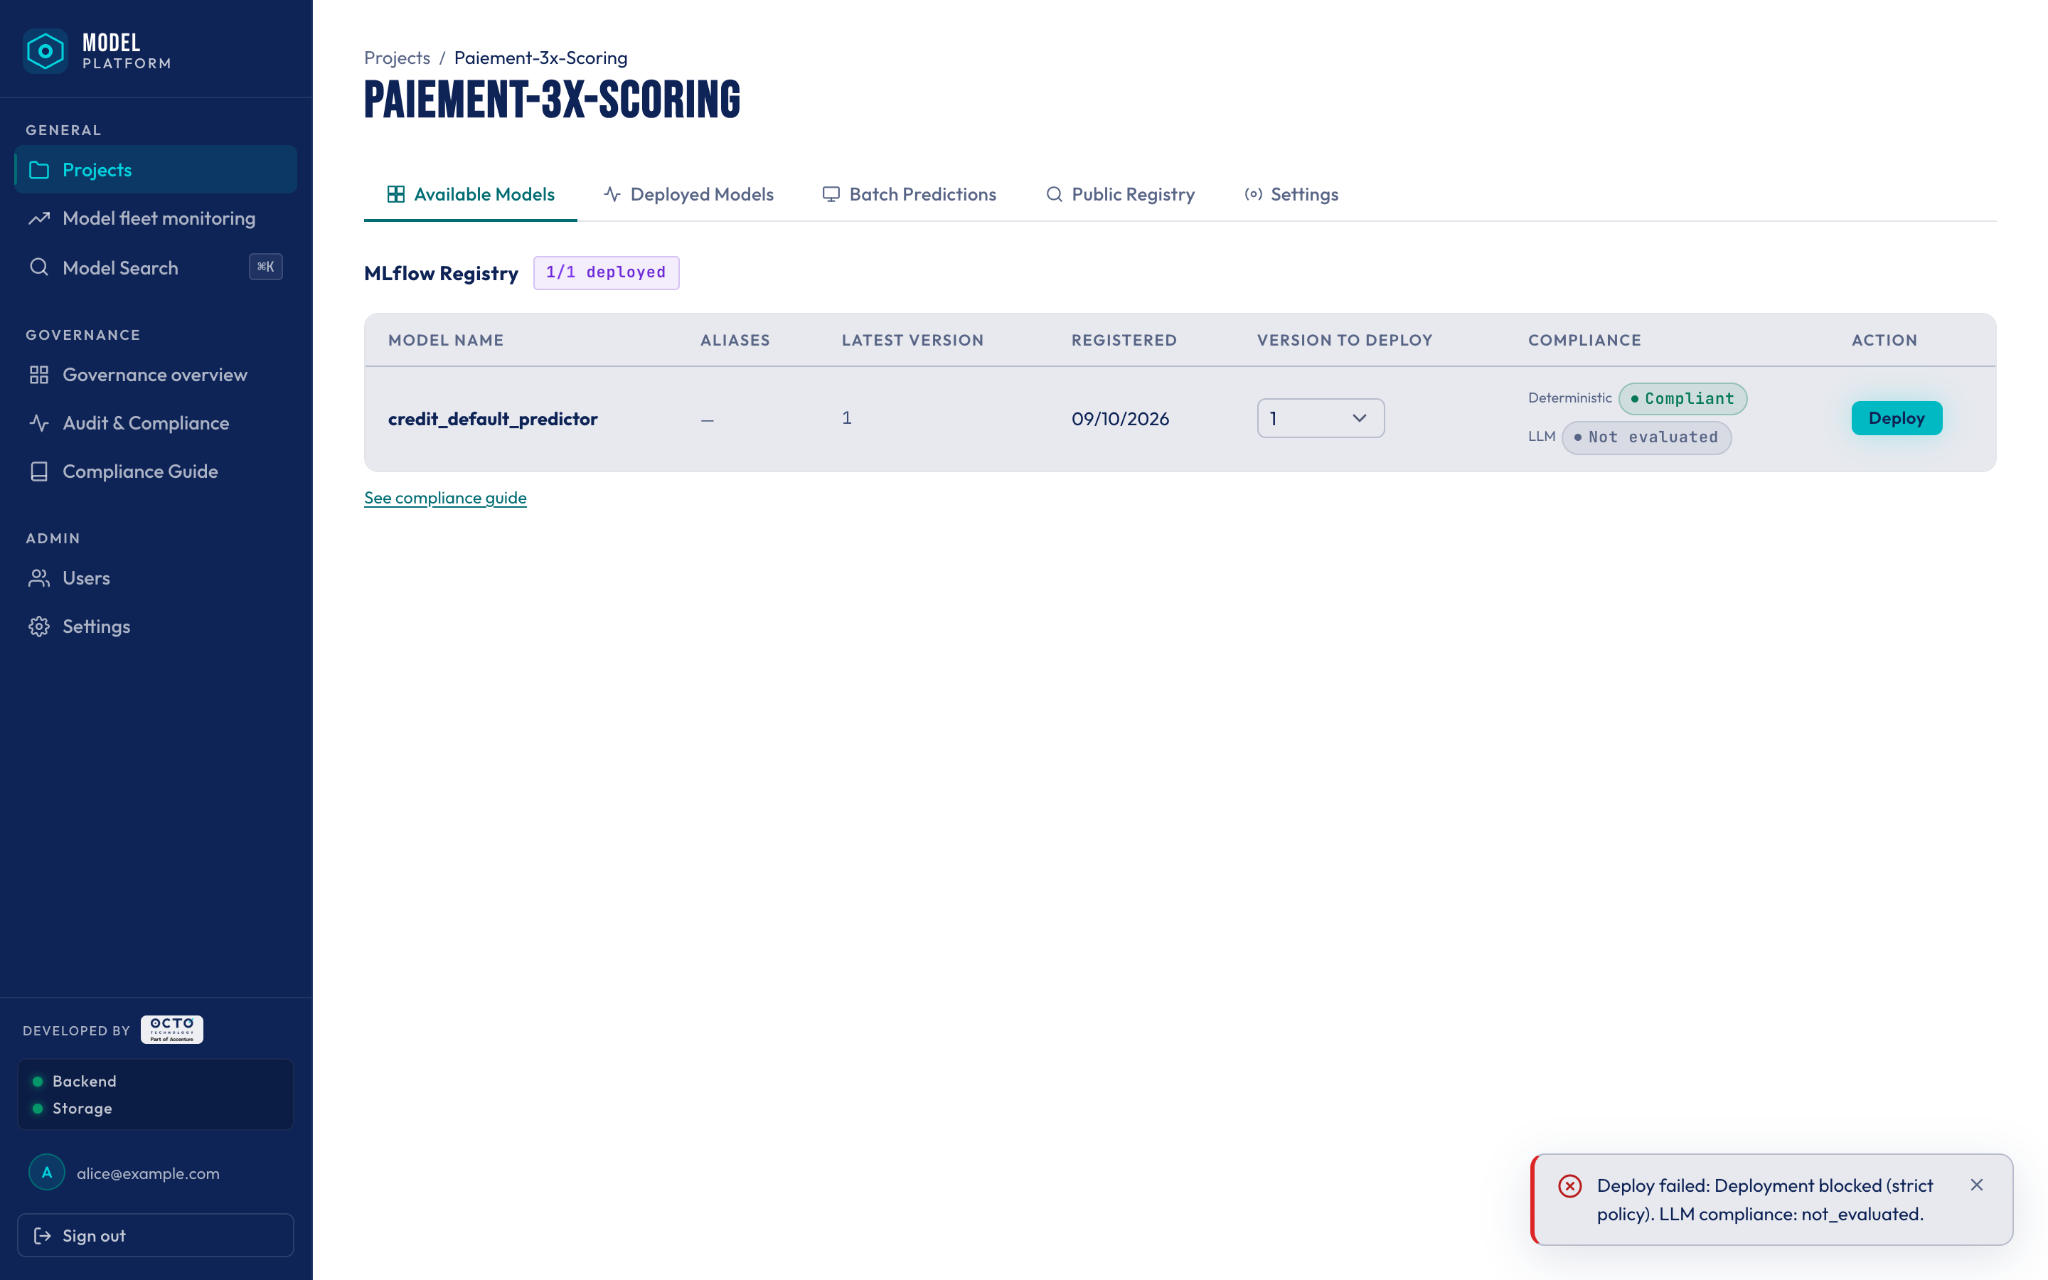
Page de gouvernance d'un projet : niveau de risque, évaluation déterministe et revue LLM pour chaque version de modèle: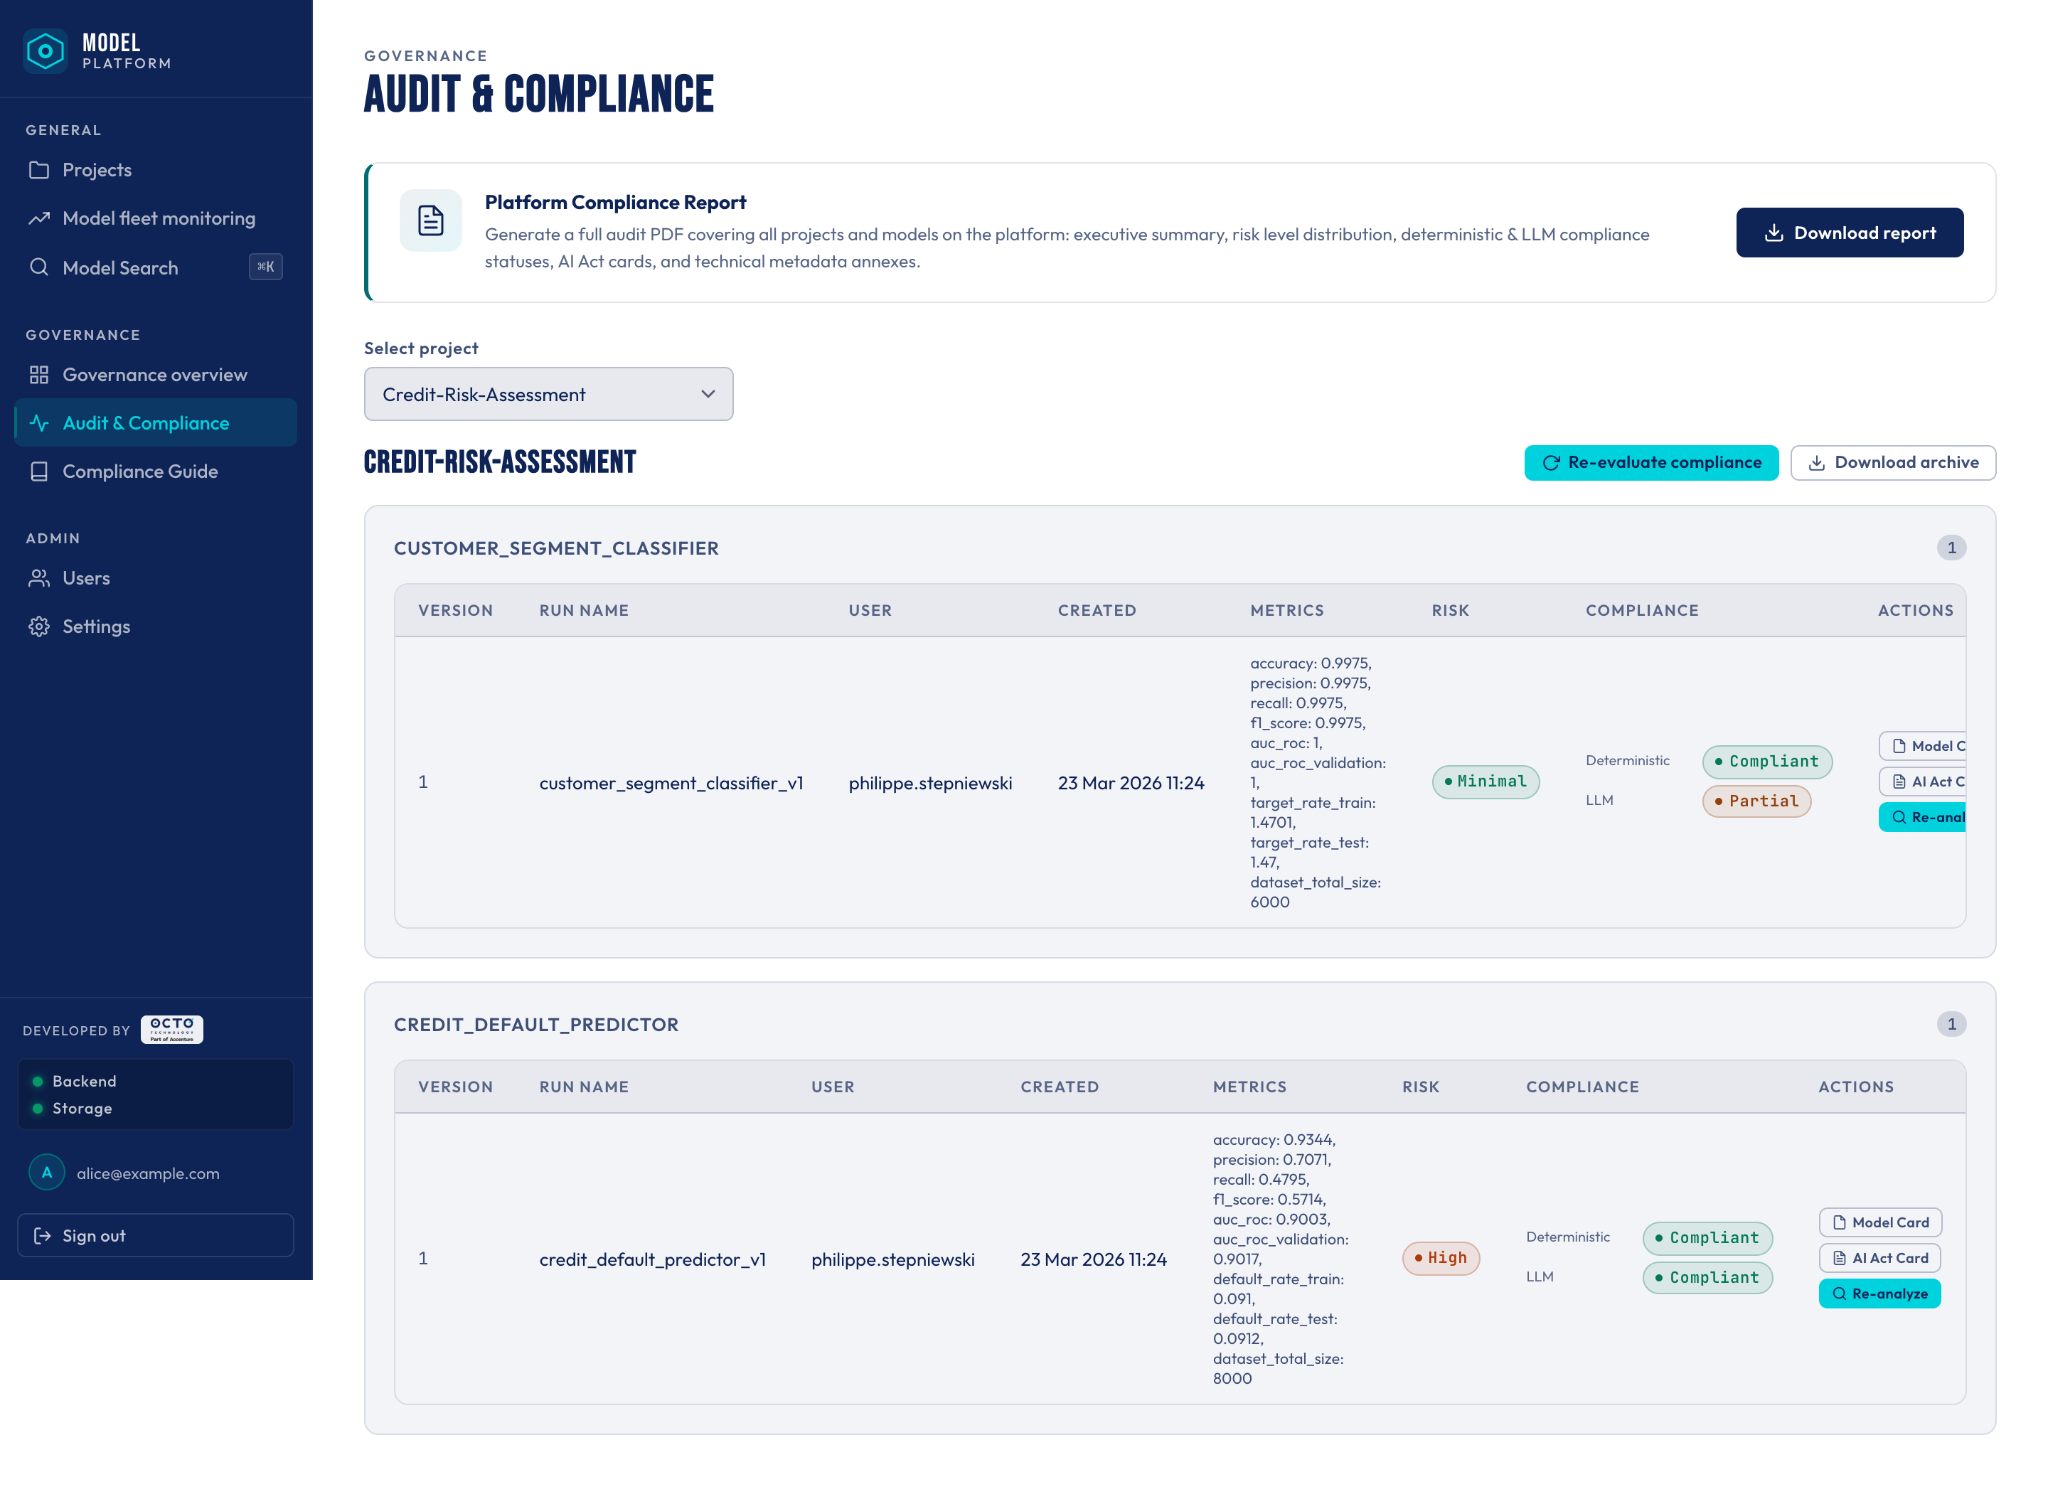
7 - Le repository et la CLI
Toute l'implémentation présentée dans cet article est disponible sur le repository GitHub d'Octo : https://github.com/octo-technology/model_platform
On y retrouve la plateforme elle-même, les manifestes Kubernetes pour la déployer, mais aussi les ADR qui ont jalonné le projet (dont celui sur MLflow évoqué plus haut). Un cluster Minikube suffit pour la faire tourner sur son poste, et le README détaille l'installation pas à pas..
Dernier point : la CLI. Tout ce qui est faisable dans l'interface l'est aussi en ligne de commande avec "mp", qu'il s'agisse de créer un projet, d'y ajouter un utilisateur, de déployer un modèle, de lancer une prédiction batch ou de rechercher un modèle dans le parc. Pour notre modèle de paiement en 3 fois, le déploiement de la version 1 tient en une ligne. L'intérêt est surtout de pouvoir brancher la plateforme dans un pipeline de CI/CD. Le déploiement d'un modèle devient alors une étape automatisée parmi d'autres, déclenchée par exemple après la validation d'une nouvelle version dans le registre, et la gate de conformité (vue dans la section 4) s'applique de la même façon qu'en passant par l'interface.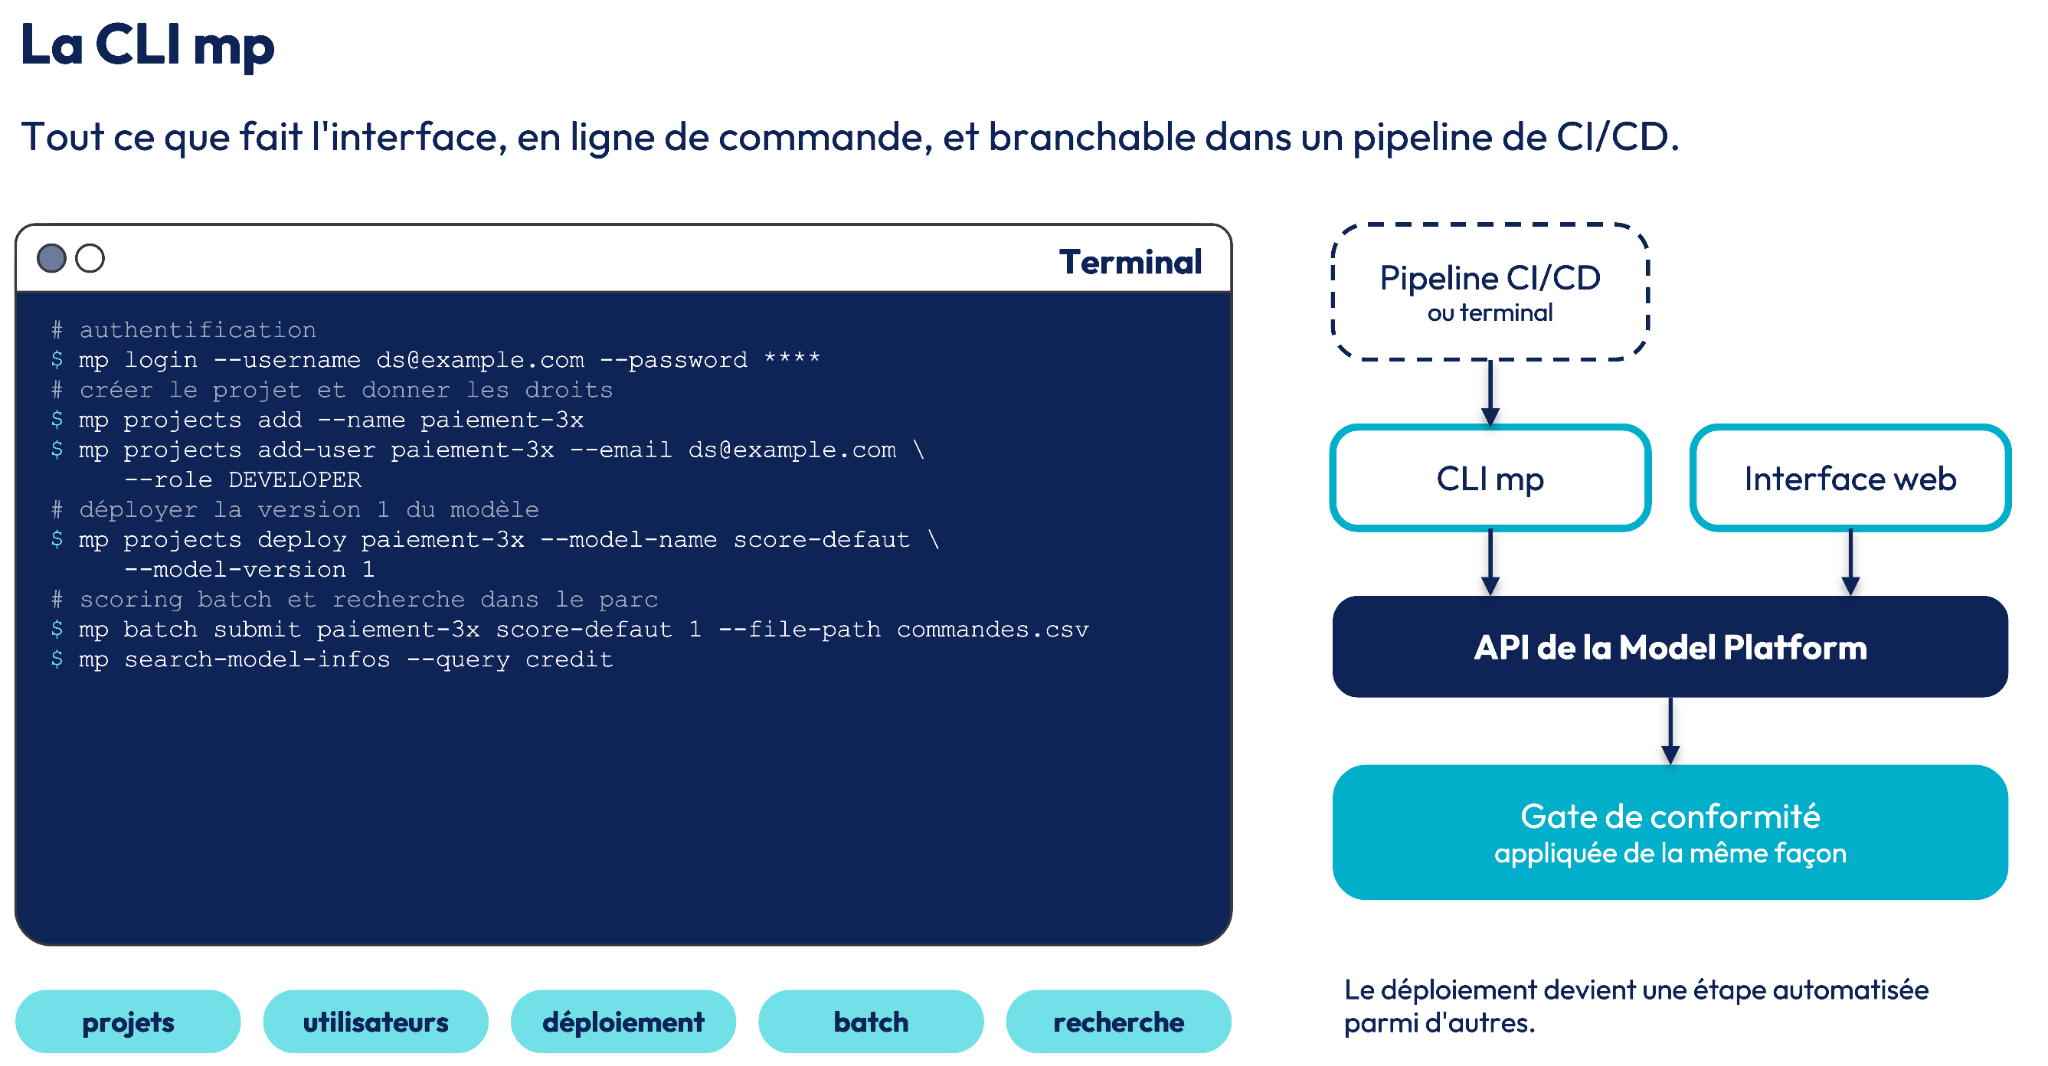
8 - Conclusion
Reprenons une dernière fois notre head of data. Avec une model platform, le modèle de paiement en 3 fois aurait été déployé en un clic, sans réunion ni ADR. Sa panne serait apparue dans la vue de flotte dès les premières erreurs, bien avant que le service des paiements ne s'en aperçoive. Et lorsque la CNIL a demandé la documentation de tous les modèles en production, la fiche de conformité de chacun existait déjà, mise à jour à chaque nouvelle version. En mode strict, aucune version ne serait d'ailleurs partie en production sans que sa fiche ait été revue (c'est probablement à ce moment-là que quelqu'un aurait remarqué la civilité parmi les variables du modèle).
Rien de tout cela n'est nouveau. Versionner les modèles à un seul endroit, standardiser leur déploiement, les monitorer systématiquement, dériver leur documentation du modèle lui-même : ce sont des bonnes pratiques MLOps connues depuis des années [2][3]. L'intérêt d'une model platform est de les appliquer par défaut, à tous les modèles de tous les projets, sans dépendre de la discipline de chaque équipe. Avec l'entrée en vigueur complète de l'AI Act le 2 décembre 2027, cette systématisation va vite devenir une nécessité.
Notre implémentation n'est évidemment qu'une réponse parmi d'autres. Le pattern que nous avons retenu (pilotage centralisé, isolation par projet) correspond à une organisation où chaque équipe reste autonome sur ses modèles, et une organisation disposant d'une équipe data centrale fera sans doute d'autres choix.
Le code est disponible sur le repository GitHub d'Octo (voir section 7), et un simple cluster Minikube suffit pour faire tourner la plateforme sur son poste.
N'hésitez pas à la tester et nous faire vos retours.
Je tiens à remercier toutes les personnes qui ont contribué à ce projet, notamment via:
- Des contributions au code : Emmanuel-Lin Toulemonde, Lissa Chen, Baptiste Courbe, Louis Delmas, Théophile Molcard, Marc Medlock.
- Du conseil sur Kubernetes : Yannig Perre
- Un accompagnement et une aide précieuse pour la partie UI/ UX : Nora Kabbani
- Octo Technology, de nous permettre de consacrer du temps à l’exploration et le développement de tels projets.
Et merci au relecteurs de cet article :
- Baptiste Courbe
- Baptiste O’Jeanson
- Emmanuel-lin Toulemonde
Références
[0] https://artificialintelligenceact.eu/fr/implementation-timeline/
[1] - Debezia, J. (2022, 16 septembre). La Grosse Conf 2025 - Model Platform : Industrialiser et gouverner vos modèles à grande échelle - OCTO Talks ! OCTO Talks ! https://blog.octo.com/la-grosse-conf-2025-model-platform--industrialiser-et-gouverner-vos-modeles-a-grande-echelle-1
[2] - Sculley, D., Holt, G., Golovin, D., Davydov, E., Phillips, T., Ebner, D., Chaudhary, V., Young, M., Crespo, J., & Dennison, D. (2015). Hidden Technical Debt in Machine Learning Systems. https://papers.nips.cc/paper_files/paper/2015/hash/86df7dcfd896fcaf2674f757a2463eba-Abstract.html
[3]- Calcagno, S. (2022, 16 septembre). Culture MLOps : le Machine Learning est un logiciel qui se délivre comme les autres - OCTO Talks ! OCTO Talks ! https://blog.octo.com/culture-mlops--le-machine-learning-est-un-logiciel-qui-se-delivre-comme-les-autres-1
[4] Toulemonde, E. L. (2022, 16 septembre). [MLOps] Monitoring & proactive notification d’une application de Machine Learning - OCTO Talks ! OCTO Talks ! https://blog.octo.com/mlops-monitoring-and-proactive-notification-d'une-application-de-machine-learning
[5] Article 3 : Definitions | EU Artificial Intelligence Act. (s. d.). EU AI Act Explorer. https://artificialintelligenceact.eu/article/3/
[6] Truong An, Vial Thomas. La Grosse Conf. (2026, April 7). Plateforme de monitoring : assurez le passage à l’échelle ! [Video]. YouTube. https://www.youtube.com/watch?v=U0-fRpxprYU