Modèle et effort de raisonnement : trouver le bon équilibre pour vos agents
Modèle et effort de raisonnement : trouver le bon équilibre pour vos agents
La plupart des fournisseurs de modèles d’intelligence artificielle permettent depuis quelques années d’ajuster le niveau d’effort de raisonnement consacré à une tâche. Cette possibilité constitue un levier important pour maîtriser la consommation de tokens, optimiser les coûts et adapter les performances à la complexité des traitements.
Pour bien comprendre comment choisir un modèle et ajuster son effort, prenons une analogie avec le football.
Dans une équipe, tous les joueurs ne possèdent ni les mêmes capacités ni les mêmes rôles. Un gardien de but, un défenseur et un attaquant remplissent des missions différentes, qui nécessitent des compétences spécifiques.
À chaque poste, un jeune espoir, un titulaire expérimenté et une superstar se distinguent également par leur maîtrise technique, leur vision du jeu et leur expérience.
Mais le talent et la spécialisation ne font pas tout. Un même joueur peut évoluer à différentes intensités, selon qu’il participe à un entraînement léger, dispute un match de championnat ou joue une finale décisive. Ses capacités restent les mêmes, mais l’énergie et la concentration qu’il mobilise varient selon l’enjeu.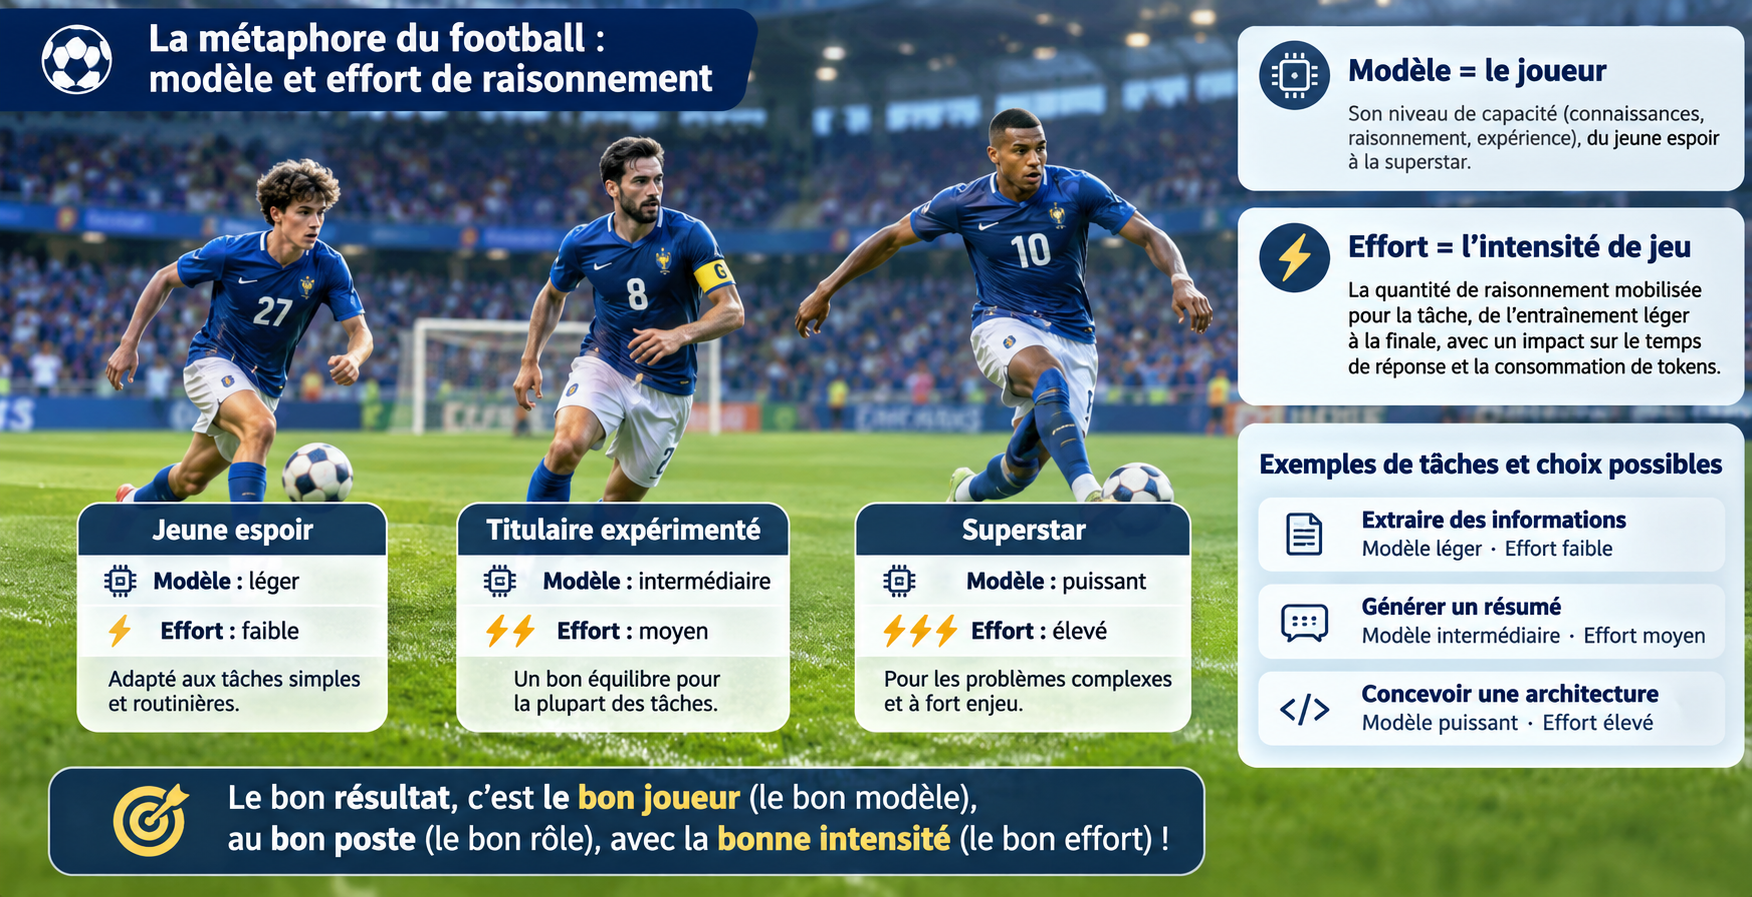
Il en va de même pour les systèmes agentiques, où trois dimensions complémentaires doivent être distinguées :
- Le rôle représente le poste du joueur : il définit la mission confiée à l’agent et les compétences attendues. Un agent peut être spécialisé dans l’extraction d’informations, l’analyse de code, la conception d’architecture ou la validation de tests.
- Le modèle représente le niveau du joueur : il détermine ses connaissances, ses capacités de raisonnement et son aptitude à résoudre des problèmes complexes. Selon la difficulté de la mission, un modèle léger peut suffire ou un modèle plus puissant peut être nécessaire.
- L’effort représente l’intensité de jeu : il détermine la quantité de travail mobilisée pour accomplir une tâche, avec des conséquences sur le temps de réponse et la consommation de tokens.
Prenons l’exemple d’une modernisation applicative. Un agent chargé d'inventorier les fichiers d'un projet peut s'appuyer sur un modèle léger avec un effort faible. Un agent chargé d'analyser les dépendances entre modules peut nécessiter un modèle intermédiaire avec un effort moyen. En revanche, un agent responsable de définir une architecture cible et d'évaluer les risques de migration pourra bénéficier d'un modèle plus puissant avec un effort élevé.
Ces choix restent indépendants. Un modèle puissant peut parfaitement accomplir une tâche simple avec un effort faible, tandis qu'un modèle plus léger peut mobiliser davantage de raisonnement pour traiter un problème à sa portée.
Comme au football, demander à un jeune joueur de se dépenser sans compter ne lui donne pas les capacités techniques d'une superstar. À l'inverse, faire jouer systématiquement son meilleur attaquant à pleine intensité, quelle que soit la rencontre, constitue rarement une bonne stratégie.
Augmenter l'effort ne transforme donc pas un petit modèle en modèle plus puissant. Et choisir un modèle puissant ne signifie pas qu'il faille systématiquement lui demander un effort maximal.
Tout l'enjeu consiste à définir le rôle de chaque agent, choisir le modèle adapté à sa mission, puis ajuster son effort à la complexité réelle de la tâche.
Dans cette organisation, l'orchestrateur joue le rôle de l'entraîneur : il compose son équipe, répartit les responsabilités et mobilise les ressources nécessaires au bon moment.
La performance d'un système agentique ne repose donc pas sur la puissance individuelle de chaque modèle, mais sur la pertinence de leur sélection, leur complémentarité et la justesse des efforts mobilisés.
Comprendre les niveaux d’effort
Toutes les tâches confiées à un modèle de langage ne nécessitent pas la même profondeur de raisonnement. Extraire une information, résumer un document ou concevoir une architecture logicielle mobilise des ressources très différentes. Pour éviter de solliciter inutilement le modèle, Anthropic propose plusieurs niveaux d’effort permettant d’adapter l’intensité du traitement à la complexité de la demande. Cette granularité offre un moyen simple de rechercher le meilleur compromis entre qualité des résultats, rapidité d’exécution et consommation de tokens.
Le paramètre effort permet ainsi de définir plusieurs niveaux de profondeur de traitement. Chaque niveau influence la manière dont Claude mobilise ses capacités pour répondre à une demande.
Le paramètre effort permet de définir plusieurs niveaux de profondeur de traitement. Chaque niveau influence la manière dont Claude mobilise ses capacités pour répondre à une demande.
| Niveau | Comportement | Utilisation recommandée |
| low | Privilégier la rapidité et une faible consommation de tokens. | Classification, extraction, tâches simples et sous-agents. |
| medium | Recherche un équilibre entre qualité, vitesse et coût. | Tâches courantes et workflows agentiques modérés. |
| high | Consacre davantage de ressources aux problèmes complexes. | Raisonnement approfondi, architecture et développement logiciel. |
| xhigh | Étend les capacités de raisonnement pour les travaux de longue durée. | Développement agentique complexe et tâches comportant de nombreuses étapes. |
| max | Mobilise le niveau d’effort le plus élevé disponible. | Problèmes particulièrement exigeants nécessitant une analyse exhaustive. |
La disponibilité de ces niveaux dépend du modèle utilisé. Tous les modèles qui prennent en charge max ne prennent pas nécessairement en charge xhigh.
Par défaut, la plupart des modèles Claude utilisent le niveau high, tandis que Claude Opus 5.5 et Claude Haiku 5.5 privilégient le medium.
Il est important de comprendre que l’effort n’est pas un budget strict de tokens, mais une indication donnée au modèle sur la profondeur de traitement attendue. Même avec un effort faible, Claude peut mobiliser davantage de raisonnement lorsqu’un problème le nécessite.
À l’inverse, augmenter systématiquement l’effort ne garantit pas une amélioration proportionnelle de la qualité. Le bon niveau dépend avant tout de la nature de la tâche.
L’effort influence toute la réponse
Le paramètre effort ne contrôle pas uniquement le raisonnement interne du modèle. Il influence également l’ensemble des tokens générés pendant son exécution, notamment les explications, les appels d’outils et leurs arguments, ainsi que la réponse finale.
Cette distinction est importante dans un environnement agentique.
Prenons un agent chargé de la rétrodocumentation d'une application existante
Pour reconstituer sa documentation technique, il explore le dépôt de code, identifie les principaux composants, analyse leurs dépendances et examine les implémentations les plus significatives, avant de reconstituer l'architecture, d'expliciter les mécanismes de fonctionnement et de produire une documentation structurée. Avec un effort faible, Claude privilégie une démarche plus directe : il regroupe plusieurs opérations, limite les appels d'outils et produit des explications concises.
On observe souvent qu'il s'appuie davantage sur des heuristiques et des hypothèses, et qu'il laisse à l'utilisateur une liste de vérifications ou d'actions à effectuer.
Avec un effort élevé, il consacre davantage de ressources à l'exploration, multiplie les vérifications, détaille ses décisions et enrichit ses recommandations. Le niveau d'effort influence donc non seulement la réponse produite, mais aussi la manière dont l'agent organise son travail. Il ne faut toutefois pas confondre effort élevé et multiplication systématique des opérations : l'objectif reste de mobiliser les ressources nécessaires, sans travail superflu.
Distinguer effort et réflexion
Anthropic distingue deux mécanismes complémentaires : la réflexion (thinking) et l'effort (effort).
- La réflexion détermine la manière dont Claude peut mobiliser un raisonnement interne avant de répondre.
- L'effort détermine la quantité de travail que le modèle consacre à l'ensemble de sa réponse.
Lorsque la réflexion adaptative est disponible, Claude peut décider lui-même quand approfondir son analyse et dans quelle mesure, et le paramètre effort permet d'orienter cette décision : avec un effort élevé, il sera généralement plus enclin à approfondir son raisonnement, et avec un effort faible, il pourra traiter directement les problèmes simples sans réflexion supplémentaire.
Les deux mécanismes ne sont donc pas concurrents : la réflexion définit une capacité de raisonnement, tandis que l'effort en ajuste l'intensité. Cette complémentarité est précieuse pour les agents autonomes, qui alternent entre des décisions simples et des problèmes nécessitant une analyse approfondie.
Activer la réflexion adaptative
L'expression « lorsque la réflexion adaptative est disponible » désigne un mode de réflexion que le modèle doit prendre en charge et qui doit être actif dans la requête. Il n'y a pas d'événement extérieur qui le déclenche : l'activation se fait en deux temps, d'abord par une configuration, ensuite par une décision que Claude prend lui-même à chaque requête.
La configuration. On l'active avec le paramètre thinking :
{
 "model": "claude-opus-5-5",
 "max_tokens": 16000,
 "thinking": { "type": "adaptive", "display": "summarized" },
 "output_config": { "effort": "medium" },
 "messages": [ { "role": "user", "content": "..." } ]
}
Selon le modèle, rien n'est parfois à écrire. Sur la série Claude 5 et Mythos Preview, la réflexion est activée par défaut. Sur Opus 4.8, 4.7, 4.6 et Sonnet 4.6, elle reste désactivée tant qu'on ne définit pas thinking: {"type": "adaptive"}. Sur Opus 4.5, Sonnet 4.5 et Haïku 4.5, le mode adaptatif n'existe pas (erreur 400) : ces modèles utilisent la réflexion à budget fixe, {"type": "enabled", "budget_tokens": N}, qui est à l'inverse refusée sur la série 5, Opus 4.7 et Opus 4.8, et dépréciée sur Opus 4.6 et Sonnet 4.6. Sur les modèles récents, le mode adaptatif est donc la voie normale. Le champ display (summarized, omitted, ou updates en bêta) ne change que l'affichage de la réflexion, pas la décision de réfléchir.
La décision. Une fois le mode actif, Claude évalue chaque requête, estime si un raisonnement plus profond améliorerait la réponse, puis décide s'il réfléchit et dans quelle mesure. Le contrôle principal de cette décision est le paramètre effort : un effort élevé rend la réflexion plus probable, un effort faible permet de répondre directement aux demandes simples. Dans une boucle agentique, la décision se représente entre les appels d'outils : Claude peut réfléchir après avoir reçu un résultat pour choisir la suite, ou sauter la réflexion lors de ces requêtes de suite, y compris à xhigh et max. La réflexion n'est donc pas un bloc unique en début de tâche, elle peut apparaître, disparaître et revenir au fil des étapes.
Précautions.
- adaptive est un mode de réflexion (thinking), pas un niveau d'effort : on ne le passe jamais comme valeur de effort.
- Demander dans le prompt de répondre directement ne suffit pas toujours à empêcher la réflexion (cas observé sur Haiku 5.5) : le bon levier est de baisser l'effort.
- Les tokens de réflexion sont facturés comme des tokens de sortie, même si le texte n'est pas renvoyé : omettre l'affichage réduit la latence, pas le coût.
- La désactivation de la réflexion dépend du modèle : sur Opus 5 et Haïku 5.5, elle n'est acceptée qu'à effort high ou inférieur, et Opus 5.5 et Sonnet 5.5 la refusent.
Configurer le niveau d’effort dans l’API Messages
Dans l’API Messages de Claude, le niveau d’effort se configure à l’aide de la propriété output_config.effort.
Par exemple, pour demander un effort moyen :
{
  "model": "claude-opus-5-5",
  "max_tokens": 4096,
  "messages": [
    {
      "role": "user",
      "content": "Analyse les compromis entre une architecture monolithique urbanisée et une architecture microservices."
    }
  ],
  "output_config": {
    "effort": "medium"
  }
}
Dans cet exemple, Claude doit analyser un problème d’architecture tout en recherchant un équilibre entre profondeur de raisonnement et consommation de ressources.
Pour une analyse plus exigeante, il suffit de remplacer medium par high, sous réserve que le modèle utilisé prenne en charge ce niveau.
Le paramètre peut également être défini sur l’objet modèle d’un agent géré ou dans la configuration de modèle d’une session.
Adapter l’effort au cours d’une conversation
La complexité d’une conversation évolue naturellement. Une première demande peut nécessiter une analyse approfondie, tandis que les échanges suivants se limitent parfois à reformuler, résumer ou clarifier les résultats obtenus.
Il serait peu efficace de mobiliser systématiquement le même niveau de raisonnement.
Anthropic permet donc, sur certains modèles, de modifier le niveau d’effort au cours d’une conversation.
Prenons un exemple : un développeur demande d’abord à Claude d’élaborer une stratégie de migration de SQLite vers PostgreSQL. Cette tâche peut justifier un effort élevé, car elle nécessite d’identifier les contraintes, les risques et les étapes de migration.
Une fois cette analyse terminée, le développeur demande simplement de résumer la stratégie en trois phrases. Un effort faible devient alors suffisant.
Deux mécanismes permettent cette adaptation.
Changement d’effort par message
Dans une application utilisant une API, une conversation se traduit par une succession d’appels, au cours desquels l’historique des échanges est transmis au modèle pour assurer la continuité du dialogue.
Dans ce contexte, le changement d’effort par message permet, sur les modèles compatibles, d’ajuster le niveau d’effort au fil de la conversation sans invalider le préfixe déjà mis en cache.
Contrairement à une modification de la configuration globale de l’appel API, cette approche consiste à insérer un message système spécifique contenant la nouvelle valeur du paramètre effort. Le modèle peut ainsi poursuivre la conversation avec un niveau d’effort différent, tout en préservant les bénéfices de la mise en cache et en limitant les coûts associés au retraitement de l’historique.
Cette fonctionnalité, actuellement en bêta, nécessite l’activation d’un en-tête spécifique (lien officiel).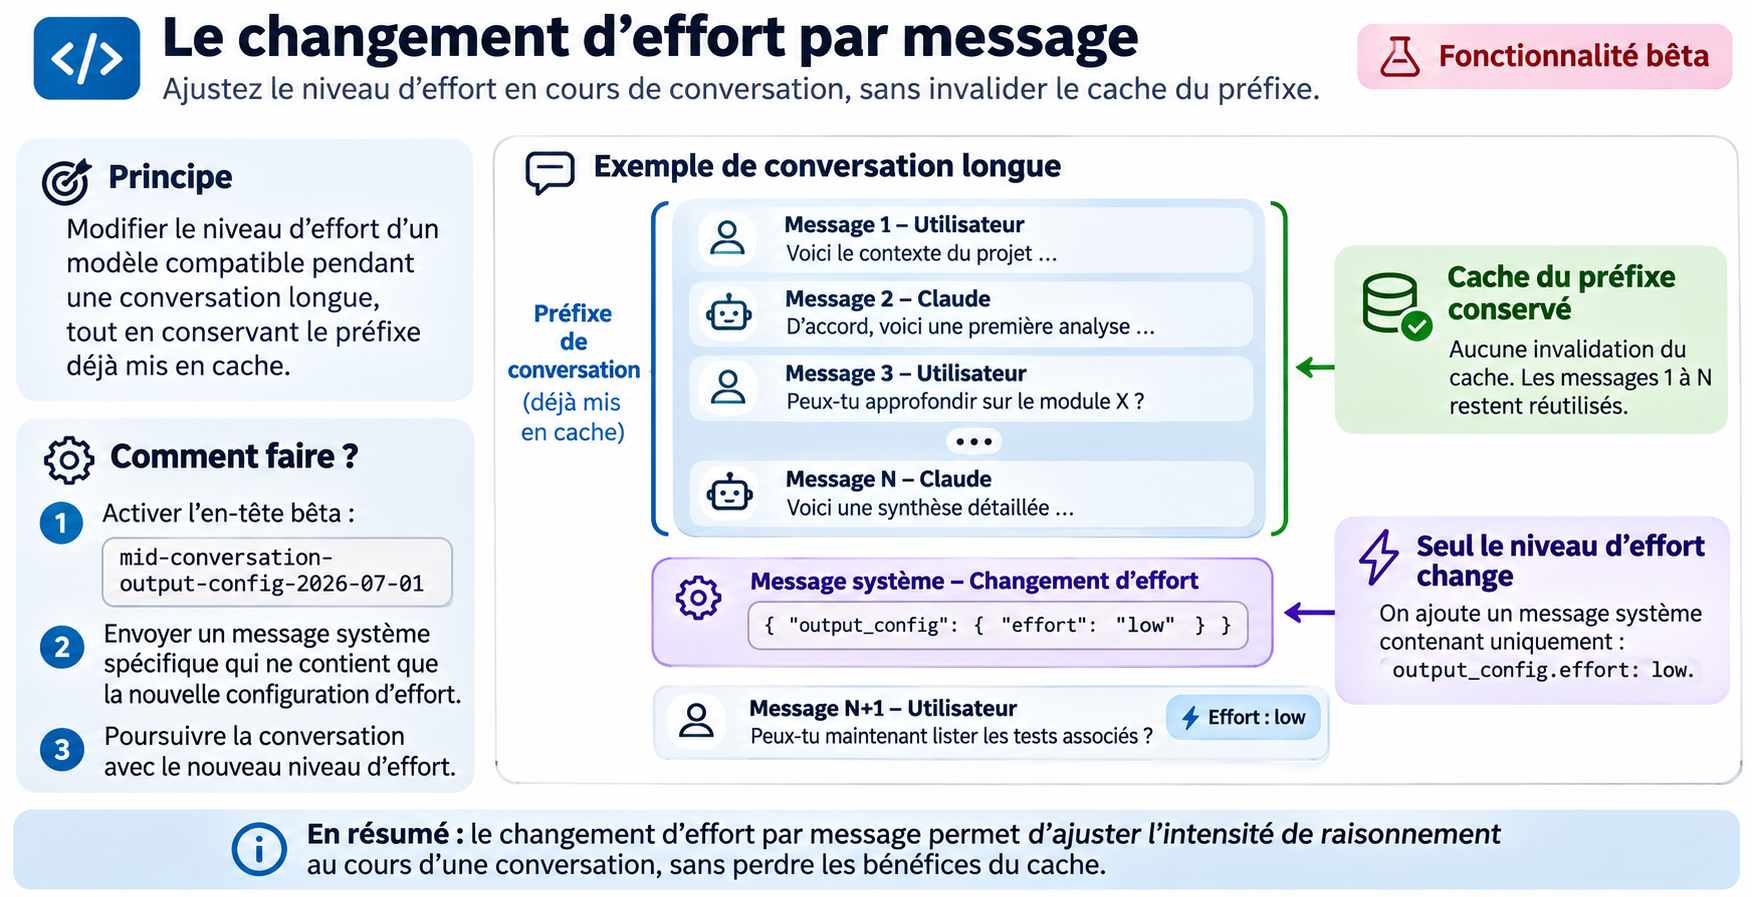
Changement d’effort au niveau de la requête
Par exemple :
« Analyse les dépendances de cette application et identifie les risques de migration. »
Puis ton application l'envoie à Claude avec un niveau d'effort high.
Pour la demande suivante, tu rédiges un nouveau prompt :
« Résume les trois principaux risques identifiés. »
L'application peut alors passer à low, soit en modifiant la configuration globale du nouvel appel API, soit en insérant un message système de changement d'effort. Cette seconde possibilité est disponible en bêta sur les modèles compatibles.
Cette approche reste simple à mettre en œuvre, mais nécessite une attention particulière dans les conversations longues, où la préservation du cache constitue un levier important d’optimisation des coûts.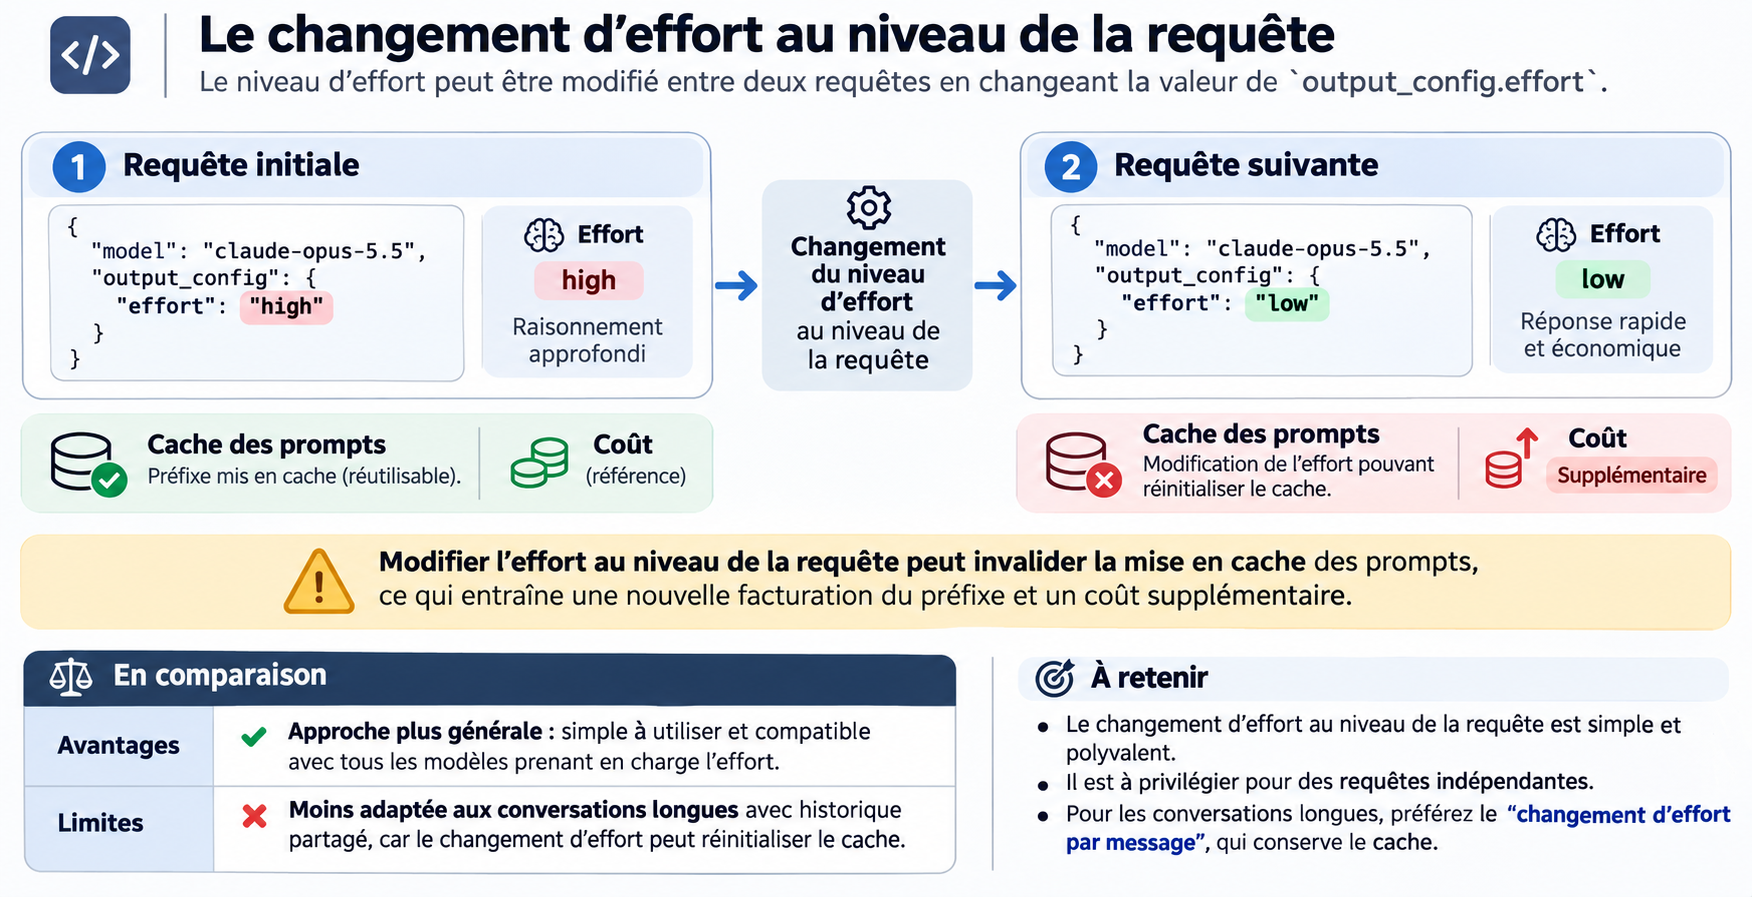
La distinction fondamentale
Dans les deux cas, l’utilisateur peut rédiger manuellement ses prompts et les transmettre au modèle à travers une succession d’appels API. La différence réside dans la manière dont le niveau d’effort est configuré :
- Par requête : le niveau d’effort est défini dans la configuration globale de chaque appel API.
- Par message : le niveau d’effort est défini dans un message système spécifique, inséré dans la conversation transmise à l’API.
Il est important de préciser que le changement d’effort par message repose également sur des appels API. Les messages sont simplement regroupés dans les requêtes successives, avec une configuration permettant d’ajuster l’effort sans invalider le préfixe déjà mis en cache.
Lorsque le modèle le permet, le changement d’effort par message est donc préférable pour les conversations longues reposant sur un historique partagé, car il permet de préserver les bénéfices de la mise en cache et de limiter les coûts associés au retraitement des informations.
Optimiser l'effort dans les systèmes multi-agents
L'intérêt du paramètre effort devient encore plus net quand un système repose sur plusieurs agents spécialisés. Imaginons un workflow de modernisation applicative dans lequel des agents collaborent pour analyser une application existante, comprendre son architecture, proposer une cible technique et préparer sa transformation. Toutes ces activités n'exigent pas la même profondeur de raisonnement. Un agent qui identifie des fichiers ou extrait des métadonnées peut fonctionner avec un effort faible. Un agent chargé d'analyser les dépendances ou de préparer les tâches peut utiliser un effort moyen. Un agent qui définit l'architecture cible ou évalue les risques de migration peut avoir besoin d'un effort élevé.
L'orchestrateur adapte ainsi le niveau d'effort à la responsabilité et à la complexité de chaque opération. On évite deux écueils : mobiliser inutilement des ressources importantes sur des tâches simples, ou sous-dimensionner le raisonnement nécessaire aux décisions critiques. Le véritable enjeu n'est pas de maximiser le raisonnement de chaque agent, mais de mobiliser le bon niveau d'intelligence au bon moment.
Augmenter l'effort ne garantit toutefois pas de meilleurs résultats : chaque tâche a ses propres exigences, et l'objectif est de mobiliser les ressources nécessaires sans consommation inutile de tokens. La documentation officielle va dans le même sens : l'effort est un signal de comportement plutôt qu'un budget strict de tokens, il modifie peu la longueur des réponses, et au-delà de high les gains deviennent inégaux selon la tâche, max étant plus lent et plus coûteux, souvent pour un gain limité. À l'inverse, un effort trop bas sur de longs prompts d'agent peut faire sauter une recherche ou une vérification. Quelques bonnes pratiques aident à trouver l'équilibre entre qualité, rapidité et coût :
- Définir explicitement le niveau d'effort selon la complexité de chaque tâche, plutôt que de garder systématiquement la valeur par défaut.
- Privilégier low pour les opérations simples et répétitives, comme la classification ou l'extraction d'informations, lorsque la rapidité et le coût sont prioritaires.
- Utiliser medium comme point de départ raisonnable pour les workflows agentiques courants, afin de viser un équilibre entre qualité, temps d'exécution et consommation de ressources. Cette recommandation est une pratique de terrain, pas une règle de documentation : la valeur par défaut est high sur la plupart des modèles et medium seulement sur Opus 5.5 et Haïku 5.5.
- Réserver high, xhigh et max aux tâches les plus exigeantes (analyse approfondie, décisions complexes, nombreuses étapes de raisonnement), selon les niveaux pris en charge par le modèle.
- Mesurer les performances sur des cas représentatifs, car l'impact du niveau d'effort varie selon les modèles, les tâches et leur contexte d'exécution.
- Préserver la mise en cache des prompts, en évitant de modifier inutilement l'effort au niveau de la requête lorsque cela risque d'invalider le cache dans les conversations longues.
Au-delà de ces principes, l'optimisation doit reposer sur des mesures concrètes : qualité des réponses, taux de réussite des tâches, nombre d'appels d'outils, consommation de tokens et temps d'exécution. Ces indicateurs permettent d'identifier les configurations les plus efficientes et d'ajuster progressivement les niveaux d'effort. Réduire l'effort n'a de sens que si la qualité reste conforme aux attentes : le véritable objectif n'est pas de consommer le moins de tokens possible, mais d'obtenir la meilleure valeur pour les ressources mobilisées.
Encadrer la consommation avec les budgets de tâches
L'effort règle la manière dont Claude traite chaque étape, mais il ne borne pas le travail total d'un agent qui enchaîne réflexion, appels d'outils et réponses. C'est le rôle des budgets de tâches (task budgets), une fonctionnalité en bêta de l'API Messages. Un budget de tâche indique à Claude combien de tokens il peut consacrer à une boucle agentique complète : réflexion, appels d'outils, résultats d'outils et texte produit. Le modèle reçoit un compte à rebours et s'en sert pour prioriser son travail et conclure proprement à mesure que le budget s'épuise. La documentation résume la différence avec l'effort en une formule : l'effort règle la profondeur, le budget règle l'étendue. Dans notre analogie sportive, l'effort est l'intensité de jeu, et le budget est le temps de jeu accordé au joueur sur le match.
Configuration
On ajoute task_budget dans output_config, à côté de effort, et on active l'en-tête bêta anthropic-beta: task-budgets-2026-03-13 :
{
 "model": "claude-opus-5-5",
 "max_tokens": 128000,
 "output_config": {
   "effort": "high",
   "task_budget": { "type": "tokens", "total": 64000 }
 },
 "messages": [
   { "role": "user", "content": "Review the codebase and propose a refactor plan." }
 ]
}
Le champ type vaut toujours "tokens" et total fixe le budget. Un champ optionnel remaining permet de reporter le reste d'un budget d'une requête à la suivante. Le minimum accepté est de 20 000 tokens : en dessous, l'API renvoie une erreur 400. La fonctionnalité est disponible sur de nombreux modèles récents (notamment Fable 5.x, Opus 5.5, Sonnet 5.5 et Haiku 5.5), mais pas sur Sonnet 5, Opus 4.6, Sonnet 4.6 ni Haiku 4.5 : il faut donc vérifier le modèle visé.
Ce que le budget compte et garantit
Le budget compte ce que Claude voit et produit pendant la tâche, et non le volume des requêtes que votre application transmet. Il couvre un tour agentique, c'est-à-dire tout ce que Claude fait en réponse à un message utilisateur qui ne contient pas de résultat d'outil, même si ce tour s'étend sur plusieurs requêtes. Un nouveau message utilisateur ouvre un nouveau tour avec un budget neuf. Le compte à rebours n'est visible que du modèle : l'API ne renvoie aucun champ « budget restant ».
Le budget n'est pas un plafond strict mais un indice de pilotage. Claude peut le dépasser s'il est au milieu d'une action plus dommageable à interrompre qu'à terminer. Le vrai plafond reste max_tokens, qui tronque la réponse. Un budget trop serré peut aussi conduire Claude à refuser la tâche, à la réduire fortement ou à s'arrêter tôt avec un résultat partiel.
| Réglage | Ce qu'il contrôle | Nature |
| effort | La profondeur de traitement de chaque étape | Signal de comportement |
| task_budget | Le travail total sur la boucle agentique | Indice de pilotage (plafond souple) |
| max_tokens | Les tokens générés dans une requête | Plafond strict |
Bonnes pratiques
- Mesurer d'abord : lancer un échantillon représentatif de tâches sans budget, puis partir du 99ᵉ centile de la consommation observée par tâche.
- Combiner avec max_tokens : le budget donne une cible à viser, max_tokens reste le garde-fou contre la génération incontrôlée.
- Augmenter le budget en premier si l'on constate des refus ou des arrêts prématurés.
- Le fixer une fois et laisser le modèle se réguler : décrémenter remaining à chaque requête, comme changer total en cours de conversation, invalide le cache de prompt. On n'utilise remaining que lorsque son propre code compacte l'historique.
- Prévoir de la marge à effort élevé : avec xhigh ou max, la documentation conseille un max_tokens d'au moins 64 000.
- Surveiller en production la consommation réelle (usage), le taux de réussite et les arrêts prématurés, pour ajuster progressivement.
Limites
Les budgets de tâches ne sont pas pris en charge dans Claude Code : on les utilise directement avec l'API Messages. Ils ne sont pas non plus disponibles dans les agents gérés, pour lesquels la documentation renvoie vers les « budgets de session », un plafond dur en dollars sur une session, que ce guide n'a pas vérifié en détail. Enfin, la documentation ne précise pas si un budget s'applique par agent ou globalement dans un système multi-agents : ce point est à tester dans votre architecture.
Combiner effort et budget
Dans l'exemple de modernisation applicative, l'agent d'inventaire peut avoir un effort faible et un petit budget, l'agent d'analyse des dépendances un effort moyen et un budget modéré, et l'agent d'architecture cible un effort élevé et un budget plus large. L'effort règle la rigueur de chaque étape, le budget borne le coût global de la boucle, et max_tokens reste le garde-fou ultime.
Vers une intelligence proportionnée au problème
L'introduction du paramètre effort marque une évolution importante dans la conception des systèmes agentiques. Il ne s'agit plus simplement de choisir un modèle et de lui confier une tâche, mais aussi d'ajuster les ressources mobilisées à la complexité du problème et à la valeur attendue.
Prenons un dernier exemple : celui d'un étudiant qui prépare son mémoire de fin d'études. Tout au long de son travail, il recherche des références bibliographiques, analyse des publications, définit une problématique, confronte des hypothèses et construit une argumentation. Pourtant, toutes ces activités ne demandent pas le même effort intellectuel : mettre en forme un chapitre ou rédiger un résumé demande généralement moins de réflexion que formuler une problématique originale ou interpréter des résultats contradictoires. La qualité de son mémoire ne dépend donc pas uniquement de ses capacités intellectuelles, mais aussi de sa capacité à concentrer ses efforts là où ils apportent le plus de valeur.
Il en va de même pour les systèmes agentiques. Choisir un modèle performant ne suffit pas : encore faut-il savoir quand exploiter pleinement ses capacités de raisonnement et quand privilégier une exécution plus rapide et moins coûteuse. Dans une architecture multi-agents, l'orchestrateur joue ici le rôle de l'étudiant qui organise son travail : il répartit les tâches, mobilise les modèles adaptés et ajuste leur effort selon la difficulté des traitements. Un bon mémoire ne se mesure pas au nombre d'heures consacrées à sa rédaction, mais à la pertinence de ses analyses et à la qualité de ses conclusions. De la même manière, la performance d'un système agentique ne se mesure pas à la quantité de raisonnement produite, mais à la valeur des résultats obtenus au regard des ressources consommées. L'enjeu n'est donc pas de maximiser le raisonnement de chaque agent, mais de mobiliser la bonne intelligence, avec le juste effort, au bon moment, afin de mieux maîtriser la consommation de tokens.
Cette maîtrise de l'effort constitue un premier levier d'optimisation. Un second mécanisme la complète : les budgets de tâches, présentés dans la section précédente, qui permettent d'encadrer la consommation globale de tokens sur l'ensemble d'une boucle agentique.
Ce qu'il faut retenir
Le modèle et l'effort sont deux curseurs indépendants. L'effort est le premier réflexe quand une réponse est trop rapide ou superficielle ; le modèle est la réponse quand le problème dépasse la capacité du joueur en place.
Réserver les gros modèles et les efforts élevés aux moments de conception et de diagnostic, et utiliser des réglages légers pour l'exécution, permet de gagner en qualité tout en maîtrisant le coût et la latence. Ce principe vaut aussi bien pour un développeur qui pilote Claude Code que pour un orchestrateur qui règle l'effort de chaque agent via l'API, avec dans ce cas une vigilance supplémentaire sur le cache de prompt et sur la mesure des résultats.